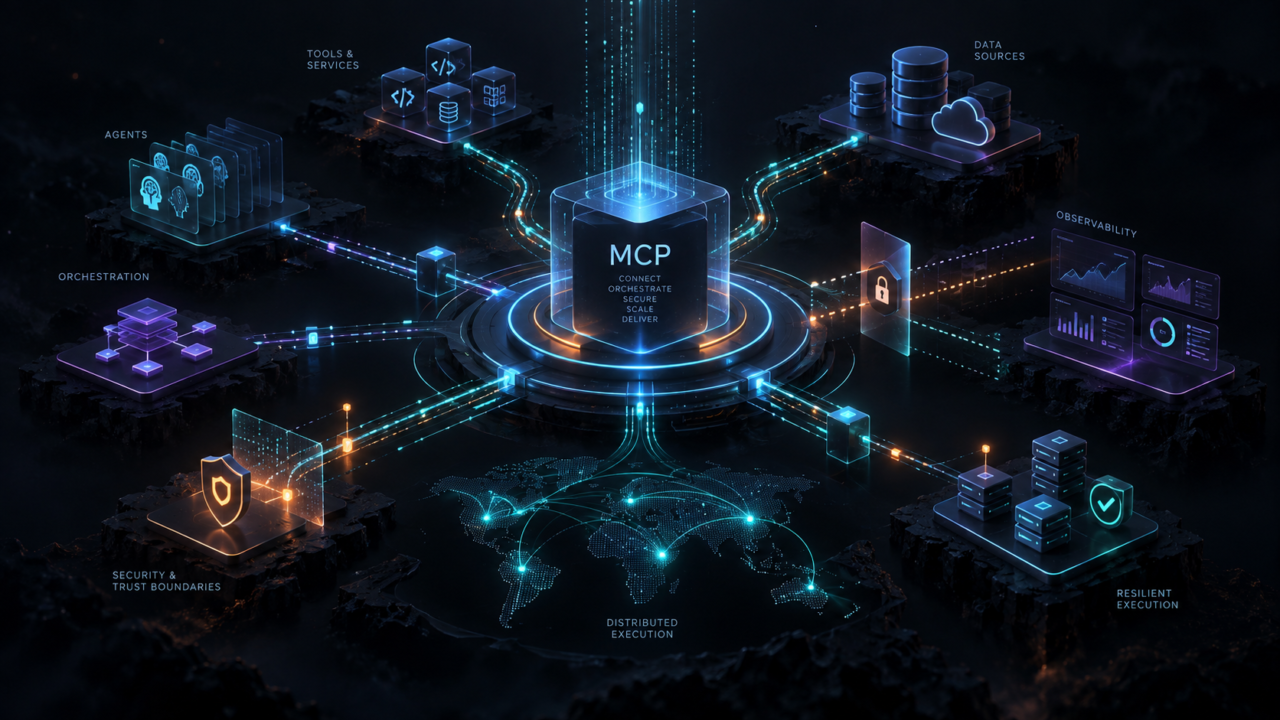
Model Context Protocol deixou de ser apenas uma conveniência para conectar LLMs a ferramentas. Em arquiteturas modernas de AI Engineering, MCP começa a ocupar uma posição semelhante àquela exercida por APIs, service meshes e event buses em gerações anteriores de sistemas distribuídos: uma fronteira padronizada entre capacidade de raciocínio e capacidade de ação. Essa mudança é importante porque agentes não apenas consultam dados. Eles selecionam ferramentas, combinam chamadas, carregam contexto entre etapas e produzem side effects em sistemas que possuem suas próprias regras de consistência, autorização e disponibilidade.
A especificação MCP 2026-07-28 reforça essa evolução ao adotar um core stateless, melhorar mecanismos de roteamento, caching e autorização e introduzir um framework formal de extensions. Tasks também passa a tratar explicitamente trabalho de longa duração. Isso torna o protocolo mais compatível com infraestrutura HTTP convencional e, ao mesmo tempo, desloca parte da complexidade para a arquitetura que circunda o protocolo.
Para um Staff ou Principal AI Engineer, portanto, a pergunta relevante não é como registrar uma tool. A pergunta é como criar uma plataforma onde milhares de execuções probabilísticas possam acessar dezenas ou centenas de capacidades determinísticas sem ampliar blast radius, latência, custo e risco operacional.
Isso exige pensar MCP como infraestrutura. Tool contracts precisam evoluir sem quebrar agentes. Identidade precisa sobreviver à cadeia de chamadas. Retries não podem duplicar pagamentos. Observability precisa correlacionar decisão, execução e efeito. Evaluation precisa medir não apenas respostas do modelo, mas comportamento sistêmico. E governança precisa permitir velocidade sem transformar cada nova integração em uma exceção arquitetural.
Fale comigo no LinkedIn: https://www.linkedin.com/in/celso-sousa/
1. MCP como infraestrutura: do protocolo de integração ao Integration Control Plane
Em pequena escala, um MCP server pode parecer apenas um adapter entre um agente e uma API. Em produção, essa interpretação rapidamente se torna insuficiente. Quando múltiplos agentes compartilham centenas de tools, vários modelos acessam as mesmas capacidades e integrações atravessam fronteiras organizacionais, o problema deixa de ser conectividade. Ele passa a ser controle distribuído sobre quem pode descobrir, selecionar e executar capacidades, sob quais políticas e com quais garantias.
Uma arquitetura madura separa o protocolo MCP da plataforma operacional que o sustenta. O protocolo define interoperabilidade. A plataforma precisa decidir discovery, authorization, routing, tenancy, quotas, observability, rollout, isolation e lifecycle. Essa distinção evita um erro comum em AI Engineering: transformar uma especificação de integração em arquitetura completa. Protocolos definem contratos; sistemas de produção precisam administrar comportamento.
A revisão 2026-07-28 torna essa separação ainda mais relevante. O core stateless permite que requisições sejam roteadas por infraestrutura HTTP convencional, enquanto informações como método e nome da capacidade podem participar de decisões de gateway. Isso reduz dependência de sticky sessions, mas aumenta a importância de metadata, routing policy e state ownership externos ao transporte.
O objetivo arquitetural deve ser construir um Integration Control Plane. Ele mantém catálogo, identidade, políticas, metadados, ownership e observabilidade enquanto o data path permanece simples e eficiente.
Essa separação permite escalar MCP como capability fabric. Agentes podem evoluir independentemente dos sistemas downstream; servidores podem mudar implementação sem expor detalhes internos; políticas podem ser alteradas sem modificar cada agente. O resultado não é apenas melhor integração. É uma infraestrutura de AI Engineering capaz de controlar execução agentic como uma disciplina operacional.
1.1. Separando Protocol Plane, Execution Plane e Control Plane
Uma arquitetura MCP de produção fica mais compreensível quando dividida em três planos independentes: Protocol Plane, Execution Plane e Control Plane. A separação não existe na especificação como obrigação arquitetural; ela é uma forma de reduzir acoplamento e tornar responsabilidades operacionais explícitas.
O Protocol Plane trata interoperabilidade. Ele conhece mensagens, schemas, capabilities, transports, version negotiation e semantics definidos pelo MCP. Seu objetivo é transformar uma intenção protocolar, como executar uma tool, em uma requisição bem formada. Esse plano não deveria decidir regras complexas de negócio, quotas específicas ou estratégias de recuperação. Quanto mais lógica organizacional for embutida nele, maior será o custo de atualização do protocolo.
O Execution Plane executa trabalho. Aqui vivem connectors, adapters, queues, workers, transaction boundaries, idempotency stores, sandboxes e integrações com APIs downstream. Se uma tool cria uma cobrança, atualiza um CRM ou inicia um workflow de minutos, é o Execution Plane que deve garantir comportamento operacional previsível.
O Control Plane governa ambos. Ele mantém registry, ownership, risk classification, policies, routing, rollout state, configuration, credentials metadata, SLOs e audit controls. Em organizações grandes, ele também define quais agentes podem descobrir determinadas capabilities antes mesmo de autorização de execução.
Essa divisão reduz blast radius. Um problema no registry não deveria interromper uma execução já autorizada. Uma falha de um connector não deveria comprometer o catálogo inteiro. Uma mudança de policy não deveria exigir redeploy de todos os MCP servers.
Para Staff Engineers, essa decomposição também melhora ownership. Protocol evolution, platform governance e runtime reliability podem evoluir em ritmos diferentes. A arquitetura deixa de ser um conjunto de servidores MCP e passa a ser uma plataforma controlável.
1.2. Topologias MCP: conexão direta, gateways, federation e MCP mesh
Não existe uma topologia MCP universalmente correta. A escolha depende de escala organizacional, trust boundaries, requisitos de latência e autonomia das equipes. O erro está em adotar uma topologia por simplicidade inicial e permitir que ela se transforme, sem intenção, em padrão enterprise.
A conexão direta entre host e MCP server possui menor complexidade e reduz hops. Ela funciona bem para integrações locais ou domínios pequenos. Entretanto, cada cliente passa a lidar com discovery, autenticação, políticas, certificados, rate limits e versões. Quando o número de relações cresce, surge um problema equivalente ao acoplamento N por M encontrado em arquiteturas de microservices.
Um MCP gateway centraliza enforcement. Ele pode validar identidade, aplicar quotas, registrar traces, filtrar capabilities e executar policy checks antes da chamada. Contudo, centralização excessiva cria um choke point operacional. Se toda lógica de negócio migrar para o gateway, ele vira um monólito de integração com alto blast radius.
Federation oferece um meio-termo. Domínios mantêm gateways ou registries próprios, enquanto contratos comuns permitem interoperabilidade entre áreas. Essa abordagem é atraente para empresas com múltiplas unidades, regiões ou requisitos regulatórios.
Uma MCP mesh leva a descentralização adiante. Capabilities podem ser descobertas e roteadas através de uma camada compartilhada, semelhante conceitualmente a service mesh, mas orientada à semântica agentic. A vantagem é autonomia; o custo é elevar muito a complexidade de policy propagation, identity federation e debugging.
A decisão deve começar pelos failure domains. Pergunte onde você aceita indisponibilidade, onde políticas precisam ser uniformes e onde latência adicional é tolerável. Topologia é consequência dessas respostas, não uma preferência estética de arquitetura.
1.3. Estado, sessões e execução stateless: definindo fronteiras de responsabilidade
Stateless não significa ausência de estado. Significa que o protocolo não exige que uma instância mantenha contexto implícito entre requisições. Essa diferença é fundamental para MCP em produção. A revisão 2026-07-28 removeu o modelo anterior baseado em handshake e session affinity do core, permitindo que requisições independentes sejam atendidas por diferentes instâncias atrás de balanceamento convencional.
O ganho operacional é significativo. Horizontal scaling deixa de depender de sticky routing ou de um session store compartilhado para requisições comuns. Rolling deployments ficam mais simples. Failover perde parte da dependência de memória local. Entretanto, todo estado que realmente pertence ao workflow continua existindo e precisa de ownership explícito.
Um agente pode manter conversation state. Um workflow pode manter execution state. Uma tool pode precisar de transaction state. Tasks long-running podem exigir checkpoints, lease ownership e status persistente. Authorization possui state próprio. Caches possuem lifecycle diferente. Colocar tudo em uma sessão MCP cria acoplamento invisível; colocar tudo no agente transfere responsabilidades demais ao orchestration layer.
Uma arquitetura robusta modela estado por semântica. Estado necessário para repetir uma operação deve viajar na requisição ou possuir um identificador persistente. Estado de workflow pertence ao runtime ou workflow engine. Dados de negócio pertencem ao sistema de registro. Estado efêmero de performance pode ficar próximo da computação.
Essa disciplina melhora retry semantics e disaster recovery. Uma instância pode desaparecer sem levar consigo a única representação de uma execução crítica. Para AI Engineering, o princípio é simples: LLM context, protocol state e business state são objetos diferentes. Confundi-los cria sistemas que parecem funcionar enquanto permanecem pequenos, mas se tornam frágeis quando começam a escalar.
1.4. Capabilities, extensions e versionamento como contratos de infraestrutura
Em ambientes distribuídos, capabilities não devem ser tratadas apenas como features anunciadas por um servidor. Elas são parte do contrato operacional entre produtores e consumidores. Um agente que assume suporte a determinada semântica sem negociação adequada introduz dependência temporal; um servidor que altera comportamento mantendo o mesmo contrato cria semantic drift ainda mais perigoso.
A evolução recente do MCP adiciona um framework formal de extensions e uma política de depreciação. Isso é relevante para arquiteturas enterprise porque separa melhor o core interoperável de capacidades que evoluem em ritmos diferentes. A especificação 2026-07-28 também introduziu mudanças importantes de lifecycle e um período formal para deprecações, reduzindo o risco de ruptura súbita.
Entretanto, protocol compatibility não garante behavioral compatibility. Uma tool pode preservar seu JSON Schema e ainda mudar unidade, ordering, limites, consistência ou side effects. Por isso, o versionamento precisa operar em múltiplas dimensões: protocol version, schema version, semantic version e policy version.
Capabilities também deveriam influenciar routing. Um cliente pode exigir suporte a determinado extension set, tamanho de payload, região ou classe de segurança. O Control Plane precisa resolver esse requisito para uma implementação elegível, não simplesmente escolher qualquer endpoint saudável.
Em organizações maduras, capability metadata também alimenta governance e evaluation. O registry deve responder quem é owner, qual SLO se aplica, quais dependências existem, qual categoria de risco representa e quais versões são suportadas.
A conclusão é importante: versionamento MCP não é apenas preocupação de SDK. Ele faz parte de change management distribuído. O verdadeiro contrato de infraestrutura precisa preservar compatibilidade sintática, operacional e semântica ao mesmo tempo.
2. MCP Design System: contratos e abstrações para uma plataforma agentic reutilizável
Escalar MCP exige mais do que criar templates de servidor. É necessário estabelecer um MCP Design System: um conjunto de decisões arquiteturais que transforma capacidades heterogêneas em interfaces previsíveis para agentes, desenvolvedores e mecanismos de governança. O objetivo não é padronizar implementação interna. É padronizar a superfície semântica que participa do raciocínio e da execução agentic.
Em APIs tradicionais, consumidores conhecem endpoints e documentação. Em sistemas agentic, o modelo frequentemente seleciona capacidades a partir de nomes, descrições, schemas e contexto. Pequenas diferenças de naming ou granularidade podem modificar tool selection, custo de inferência e taxa de erro. Isso transforma interface design em parte da qualidade do sistema de IA.
Um design system maduro define convenções para naming, description, input schema, output schema, error taxonomy, side-effect annotations, pagination, idempotency, timeout expectations e observability metadata. Também precisa diferenciar operações de leitura, mutação e execução longa.
O desafio é evitar dois extremos. Contratos excessivamente genéricos produzem ferramentas ambíguas e difíceis de selecionar. Contratos específicos demais explodem o catálogo e aumentam o search space disponível ao modelo. O design ideal reduz entropia sem esconder capacidades importantes.
Outro ponto central é ownership. Uma tool não deveria existir sem uma equipe responsável, uma classificação de risco e uma política de lifecycle. Registry e CI podem validar essas propriedades antes da publicação.
Quando tratado dessa forma, MCP Design System funciona como uma camada de arquitetura organizacional. Ele melhora interoperabilidade, evaluation e segurança simultaneamente. Mais importante, permite que novos MCP servers entrem no ecossistema sem obrigar cada agente a reaprender padrões diferentes de interação.
2.1. Tool contracts: granularidade, schemas, namespaces, invariantes e semantic boundaries
O contrato de uma tool influencia diretamente o comportamento do agente. Nome, descrição e schema não são documentação passiva; eles participam do mecanismo de decisão do modelo. Portanto, tool design precisa combinar princípios de API design com princípios de machine-readable affordance.
Granularidade é o primeiro trade-off. Uma tool genérica como execute_action reduz o número de ferramentas, mas transfere semântica para parâmetros livres e dificulta authorization, evaluation e observability. No extremo oposto, dezenas de tools quase idênticas ampliam o catálogo e aumentam collisions na seleção. A fronteira adequada normalmente coincide com uma capability de negócio com invariantes claros.
Schemas devem reduzir graus de liberdade. Enums, formatos, constraints, discriminated unions e relações condicionais são preferíveis a strings abertas. O suporte atual a JSON Schema mais expressivo permite modelar contratos com composição e referências, mas complexidade excessiva também pode degradar interpretabilidade e compatibilidade entre implementações.
Namespaces evitam colisão e comunicam ownership. Um padrão como payments.refund.create carrega mais informação operacional que refund. Entretanto, nomes não devem codificar topologia física; migrar um backend não deveria alterar a identidade semântica da capability.
Invariantes precisam ser explícitas. Se create_transfer garante at-most-once apenas mediante idempotency key, isso faz parte do contrato. Se resultados possuem eventual consistency, o consumidor precisa saber.
Semantic boundaries também importam. Uma tool deve representar intenção estável, não uma sequência acidental de endpoints internos. O agente deveria pedir “criar reembolso”, não “POST /v2/refund”.
Esse desenho reduz coupling e melhora evaluation. É possível medir se o modelo escolheu a capability correta sem confundir a métrica com detalhes da implementação. Para Staff Engineers, essa separação é essencial para permitir evolução independente entre agentes e plataformas de negócio.
2.2. Tools, resources e prompts: escolhendo a abstração correta para cada integração
Tools, resources e prompts representam semânticas diferentes e deveriam ser utilizados deliberadamente. Tratar tudo como tool aumenta complexidade de segurança e polui o espaço de decisão do agente. Tratar tudo como resource reduz capacidade de ação. A escolha correta começa pela natureza da interação, não pela conveniência do SDK.
Tools representam operações executáveis. Elas podem consultar, transformar ou alterar estado. Como participam de uma decisão de ação, precisam de contracts mais fortes em torno de autorização, timeout, retries e side effects. Uma tool que modifica dados deveria ser classificada de forma diferente de uma função determinística de leitura.
Resources representam informação endereçável. São apropriados quando o valor principal está em fornecer contexto com identidade e lifecycle próprios. Catálogos, documentos, configurações e artefatos podem ser expostos dessa maneira sem transformar cada acesso em uma ação semanticamente equivalente.
Prompts oferecem templates ou estruturas reutilizáveis de interação. Em plataformas enterprise, seu valor está menos em armazenar strings e mais em versionar padrões de comportamento e contexto. Contudo, prompts não deveriam se tornar uma segunda camada invisível de lógica de negócio. Quando uma regra precisa ser determinística, ela pertence a código ou policy.
A decisão também impacta evaluation. Tool selection pode ser avaliada por precision e task success. Resource retrieval exige freshness, relevance e authorization correctness. Prompts precisam de regressão comportamental e version tracking.
Uma boa arquitetura evita sobreposição. Se o mesmo objeto pode ser obtido como resource e por três tools diferentes, o agente enfrenta escolhas desnecessárias.
O princípio é reduzir ambiguidade sem reduzir expressividade. MCP funciona melhor quando cada primitive comunica claramente o tipo de interação esperado. Essa clareza melhora planning, segurança e observabilidade ao mesmo tempo.
2.3. Registry, discovery, metadata e policy-driven routing em ecossistemas distribuídos
Quando uma organização possui poucos MCP servers, discovery pode ser estático. Em escala, isso deixa de funcionar. Um registry passa a exercer função semelhante a um service catalog, mas com metadata adicional orientada ao comportamento agentic. Ele não deveria apenas responder onde uma capability está; deveria descrever quando, por quem e sob quais condições ela pode ser utilizada.
O registry ideal mantém identidade estável da capability, owner, versões, schemas, endpoint classes, regiões, dependências, risk tier, data classification, SLO, deprecation state e políticas aplicáveis. Essa metadata alimenta clients, gateways, evaluation pipelines e ferramentas de governança.
Discovery também precisa ser filtrado. Mostrar todas as tools disponíveis para todo agente pode aumentar custo de contexto e degradar tool selection. Em vez disso, o sistema pode construir um capability set baseado em tenant, role, workflow, modelo, região e intenção corrente. Esse mecanismo reduz search space antes que o LLM precise raciocinar sobre ele.
Policy-driven routing transforma metadata em decisão operacional. Uma operação pode ser roteada para uma implementação regional por data residency, para um provider específico por custo ou para uma versão canary durante rollout. O agente não precisa conhecer essas escolhas.
Caching do catálogo também é relevante. A especificação atual inclui hints como ttlMs e cacheScope para respostas de listagem e leitura, permitindo reduzir requisições redundantes sem assumir freshness indefinida.
Porém, registry não deve virar dependência síncrona obrigatória de toda execução. Capabilities já resolvidas podem utilizar caches locais e políticas compiladas.
Esse desenho cria separação entre descoberta e execução. O resultado é um ecossistema onde agentes trabalham com interfaces estáveis enquanto infraestrutura decide dinamicamente qual implementação satisfaz requisitos técnicos e de governança.
2.4. Contract evolution: compatibility, deprecation, migration e controle de semantic drift
Contratos MCP evoluem em uma dimensão particularmente difícil: consumidores podem incluir LLMs. Isso significa que mudanças aparentemente compatíveis para software tradicional podem alterar comportamento probabilístico. Modificar uma descrição, renomear um parâmetro ou adicionar uma tool semelhante pode mudar distribuição de tool selection mesmo quando nenhum schema foi quebrado.
Por isso, contract evolution precisa diferenciar backward compatibility sintática de behavioral stability. Uma mudança em enum pode quebrar parsing. Uma mudança textual pode quebrar decisão. Uma mudança de latência pode alterar timeout behavior. Uma alteração de consistência pode gerar decisões baseadas em dados stale.
Toda evolução relevante deveria passar por contract tests e behavioral evaluation. Um dataset de intents pode medir alterações na seleção de ferramentas antes e depois da mudança. Traces históricos podem ser replayed contra uma nova versão. Shadow evaluation permite comparar outputs sem produzir side effects.
Deprecation precisa ser gradual. O registry pode marcar uma versão como deprecated, impedir novos consumidores e manter compatibilidade para workloads existentes. Métricas devem mostrar quais clientes continuam utilizando a versão anterior antes da remoção.
Migration também pode ocorrer por routing. Um Control Plane consegue direcionar uma fração de chamadas para uma nova implementação sem alterar a identidade pública da capability. Isso permite canary releases no nível semântico.
Semantic drift merece atenção contínua. A implementação de uma tool pode permanecer tecnicamente compatível enquanto o backend muda comportamento. Por isso, invariantes críticas precisam de testes end-to-end.
O objetivo não é impedir mudança. É tornar mudança observável e reversível. Para plataformas de AI Engineering, isso é ainda mais importante porque regressões podem surgir como pequenas alterações estatísticas na trajetória do agente, e não como erros HTTP facilmente detectáveis.
3. Security Architecture: identidade, autorização e contenção de risco entre trust boundaries
MCP amplia a superfície de ataque porque conecta modelos capazes de interpretar conteúdo não confiável a sistemas capazes de produzir efeitos reais. A fronteira de segurança não está apenas entre cliente e servidor. Ela atravessa usuário, agente, modelo, contexto recuperado, MCP host, gateway, server, credentials e sistemas downstream.
A consequência arquitetural é clara: autenticação não basta. Uma chamada pode estar corretamente autenticada e ainda ser inadequada para o contexto atual. Security Architecture precisa tratar identidade, intenção, capability, dados e risco como dimensões separadas.
O primeiro princípio é evitar ambient authority. Um agente não deveria herdar um conjunto amplo de credenciais simplesmente porque está executando dentro de um ambiente privilegiado. Capabilities precisam ser concedidas com escopo mínimo e, quando possível, ligadas à identidade efetiva do usuário ou workload.
O segundo princípio é reduzir propagation de confiança. MCP server não deve assumir que argumentos são seguros porque vieram de um LLM aprovado. O servidor continua responsável por validação, autorização e business invariants.
O terceiro princípio é tornar side effects proporcionalmente mais difíceis que leitura. Operações destrutivas ou irreversíveis podem exigir policy checks adicionais, approvals ou confirmation tokens.
A evolução recente do MCP fortaleceu o modelo de autorização e aproximou o protocolo de práticas modernas de OAuth e OpenID Connect, incluindo mudanças na identificação de clientes e validação de issuer.
Para Staff Engineers, o objetivo não é criar segurança específica para cada tool. É construir primitives reutilizáveis para identidade, policy enforcement, credential isolation e auditabilidade. Isso reduz inconsistência e impede que a segurança da plataforma dependa da disciplina individual de cada equipe de integração.
3.1. OAuth, credential isolation e propagação segura de identidade entre agentes e MCP servers
Identidade em MCP precisa responder a três perguntas diferentes: quem iniciou a ação, qual workload está executando a ação e qual serviço finalmente acessará o sistema de destino. Colapsar essas identidades em um único token simplifica implementação, mas destrói rastreabilidade e amplia privilégio.
Em um fluxo enterprise, o usuário pode autenticar-se no host; o host executa um agente; o agente acessa um MCP server; o servidor chama uma API downstream. Cada hop precisa preservar apenas os atributos necessários para a decisão seguinte. Isso é diferente de simplesmente encaminhar o access token original.
Token passthrough irrestrito é especialmente perigoso. O recurso downstream pode aceitar scopes que o MCP server nunca deveria exercer. Além disso, um token emitido para um audience não deveria ser reutilizado contra outro recurso. A documentação atual do MCP reforça validação de issuer, identificação do protected resource e restrição de tokens ao recurso apropriado.
Credential isolation significa que secrets não devem aparecer no contexto do LLM nem viajar como parâmetros de tool. O runtime resolve credenciais por referência segura, idealmente usando short-lived tokens, workload identity ou secret broker.
Delegation também precisa ser explícita. Uma chamada “em nome do usuário” possui implicações diferentes de uma chamada service-to-service executada pela plataforma. Audit logs devem conservar essa distinção.
A arquitetura mais robusta mantém um identity context estruturado: subject, actor, tenant, workload, assurance level, scopes e policy attributes. Cada servidor deriva apenas a autorização necessária.
Esse desenho oferece um benefício adicional: modelos podem ser substituídos sem alterar o modelo de confiança. O LLM decide uma intenção; a infraestrutura continua controlando autoridade. Em AI Engineering seguro, inteligência e privilégio nunca deveriam ser a mesma coisa.
3.2. Least privilege, autorização contextual e controle de acesso por tool, tenant e intenção
Role-Based Access Control é frequentemente insuficiente para sistemas agentic. Um usuário pode possuir permissão geral para determinada operação, mas isso não significa que qualquer agente, em qualquer workflow, deveria poder executá-la automaticamente. A autorização precisa considerar contexto operacional.
Uma política madura pode combinar RBAC, ABAC e capability-based security. RBAC define papéis amplos. ABAC incorpora atributos como tenant, região, classificação do dado, canal e horário. Capabilities delimitam a autoridade específica concedida a uma execução.
O ponto mais importante é authorization at execution time. Tool discovery pode esconder capabilities não permitidas, mas isso é apenas otimização e defesa adicional. O servidor precisa validar novamente a operação quando ela for chamada. O modelo pode produzir nomes ou argumentos inesperados; discovery filtering não pode ser tratado como enforcement.
Intenção também pode participar da política, porém com cuidado. Uma classificação produzida pelo próprio LLM não deve ser única evidência para liberar uma ação crítica. O sistema pode usar workflow state, approval tokens ou atributos emitidos por componentes determinísticos para representar intenção verificada.
Multi-tenancy exige isolamento explícito. Tenant ID não deveria ser aceito livremente como argumento se já puder ser derivado da identidade. Caso contrário, uma simples alucinação pode virar cross-tenant access.
Least privilege deve chegar ao backend. Se a tool só precisa consultar invoices, sua service identity não deveria possuir permissão para atualizar customers.
Esses controles também ajudam evaluation. É possível criar testes adversariais que verificam se um agente consegue ultrapassar sua policy boundary.
A arquitetura correta assume que o modelo pode escolher uma ação inadequada. Segurança não depende de o modelo “obedecer”. Ela depende de impedir deterministicamente que decisões probabilísticas adquiram autoridade além do que foi concedido.
3.3. Prompt injection, tool poisoning, confused deputy e exfiltração através da cadeia agentic
Prompt injection em sistemas MCP não é apenas um problema de texto malicioso. Ela pode alterar o caminho de execução do agente e induzir uso de ferramentas com autoridade real. Quando contexto externo, documentos, websites ou resultados de tools entram no prompt, conteúdo não confiável pode tentar redefinir objetivos, solicitar secrets ou redirecionar chamadas.
Tool poisoning amplia o problema. Metadata, descrição ou output de uma ferramenta podem conter instruções que influenciam decisões posteriores. Em um ecossistema com servidores de terceiros, isso transforma cada integração em uma potential trust boundary.
Confused deputy ocorre quando um componente privilegiado executa uma ação em nome de uma entrada menos privilegiada sem verificar se a autoridade deveria ser usada naquele contexto. Um agente com acesso a e-mail e armazenamento pode, por exemplo, ser induzido a copiar informações entre domínios que individualmente seriam permitidos.
A defesa exige controles em camadas. Conteúdo de resources e tools deve ser tratado como data, não como policy. Sensitive operations precisam de authorization independente da justificativa textual do modelo. Outputs devem ser classificados antes de ingressarem em contextos mais privilegiados.
Data loss prevention pode atuar em egress. Policy engines podem impedir que dados classificados sejam enviados para tools externas. Taint tracking, mesmo que aproximado, pode registrar origem e sensibilidade de context fragments.
Outra medida é capability segmentation. Um agente que lê conteúdo público não deveria simultaneamente possuir acesso irrestrito a secrets ou operações financeiras.
Evaluation adversarial precisa combinar múltiplas tools. Testes isolados não capturam ataques composicionais.
O princípio arquitetural é manter separação entre informação e autoridade. O modelo pode ler uma instrução arbitrária, mas essa instrução nunca deveria criar privilégio novo dentro do runtime.
3.4. Sandboxing, secrets, egress control e approval gates para operações com side effects
Tools que executam código, manipulam arquivos ou acessam redes externas exigem isolamento maior que integrações puramente declarativas. O MCP contract define a interface; ele não fornece automaticamente uma sandbox segura para a implementação. Essa responsabilidade permanece na arquitetura de execução.
Sandboxing deve assumir que inputs podem ser adversariais. Containers isolados, microVMs ou ambientes restritos podem limitar filesystem, processos, network namespaces, CPU, memória e duração. O nível de isolamento deve acompanhar o risco. Uma transformação de JSON não precisa do mesmo runtime de uma tool que executa código arbitrário.
Secrets nunca deveriam ser injetados no prompt ou retornados ao modelo quando o objetivo real é apenas autenticar uma chamada. Um secret broker pode disponibilizar credenciais diretamente ao connector, com escopo e TTL mínimos. Isso reduz exposição em logs, traces e context windows.
Egress control é igualmente importante. Uma tool comprometida não deveria conseguir enviar dados para qualquer domínio. Allow lists, private endpoints, DNS controls e network policies reduzem canais de exfiltração.
Approval gates devem ser usados onde o custo de um erro supera a vantagem da autonomia total. Aprovação pode ocorrer antes da execução, antes do commit ou após uma dry run. O padrão mais forte separa planning de authorization: o agente propõe a ação, um componente determinístico calcula impacto e uma política decide se aprovação humana é necessária.
O desafio é não transformar toda interação em consent fatigue. Risk tiers permitem reservar gates para ações realmente sensíveis.
A meta não é impedir agents de agir. É criar uma fronteira em que aumento de autonomia não implique aumento linear de risco. Uma plataforma bem desenhada faz operações seguras parecerem fáceis e operações perigosas exigirem evidência adicional.
4. Execution Runtime: projetando MCP para falhas, concorrência e workflows long-running
MCP padroniza interação, mas confiabilidade de execução continua sendo um problema de distributed systems. A partir do momento em que uma tool chama outra API, grava estado, publica eventos ou inicia trabalho assíncrono, entram em cena partial failures, timeouts, retries, duplicate delivery e inconsistência temporal.
O erro mais comum é tratar uma chamada de tool como uma função local. Em produção, ela representa uma cadeia de dependências com diferentes failure semantics. O cliente pode perder a resposta depois de o servidor concluir a operação. O servidor pode falhar após gravar estado e antes de confirmar. O backend pode aceitar uma requisição e responder tarde. Nenhuma dessas situações é rara em escala.
Por isso, Execution Runtime precisa fornecer primitives reutilizáveis: deadlines, cancellation, idempotency, deduplication, checkpointing, task state, retries, circuit breakers e backpressure. Deixar cada MCP server implementar esses mecanismos isoladamente produz comportamentos incompatíveis.
Long-running work merece tratamento próprio. A extensão Tasks reflete justamente a necessidade de representar operações que não cabem no ciclo simples request-response. Entretanto, protocolo de task não substitui workflow durability. Persistência, recovery, ownership e compensação continuam sendo decisões da plataforma.
Outro ponto é concurrency control. Dois agentes podem chamar simultaneamente tools que modificam o mesmo recurso. A plataforma precisa respeitar invariantes do domínio, seja por optimistic concurrency, locks, serialized commands ou mecanismos do sistema downstream.
A função do runtime é transformar falhas inevitáveis em comportamento previsível. Para AI Engineering, isso é essencial porque agentes adicionam não determinismo na decisão. O restante da infraestrutura precisa compensar oferecendo deterministic guarantees onde elas são possíveis.
4.1. Idempotency, deduplication e consistência em operações que produzem side effects
Retries são inevitáveis em sistemas distribuídos; duplicar side effects não deveria ser. Toda tool que cria, cobra, envia, publica ou altera estado precisa definir explicitamente sua estratégia de idempotency.
Uma idempotency key deve representar a intenção lógica, não uma tentativa de transporte. Se o agente tenta criar o mesmo pagamento após timeout, a chave precisa permanecer estável. Gerar um novo identificador para cada retry elimina justamente a proteção desejada.
O servidor pode manter um deduplication store que mapeia key para status e resultado. Entretanto, TTL desse registro precisa ser maior que a janela realista de retry. Uma chave expirada cedo demais transforma uma recuperação tardia em duplicação.
Idempotency também possui escopo. A mesma chave pode ser válida por tenant, usuário ou capability. Essas dimensões precisam fazer parte do namespace para evitar colisões.
Nem toda operação pode ser estritamente idempotente. Nesses casos, pode ser necessário usar transaction identifiers, conditional writes ou compensating actions. Em sistemas financeiros, por exemplo, exatamente-once end-to-end geralmente depende de invariantes do ledger, não de uma promessa do transporte.
Consistency também precisa ser comunicada. Depois de create_order retornar sucesso, uma leitura subsequente pode ou não enxergar o pedido imediatamente. Se existe eventual consistency, o agente precisa receber status suficiente para não interpretar atraso como falha e repetir a criação.
A melhor tool contract expõe identidade do efeito produzido. Retornar apenas “success” perde informação útil para reconciliar retries.
Para Staff Engineers, o objetivo é definir failure semantics antes do happy path. Pergunte o que acontece se a resposta desaparecer, se duas chamadas chegarem juntas ou se o downstream aceitar parcialmente. Essa análise transforma uma integração aparentemente simples em um componente realmente confiável.
4.2. Retries, exponential backoff, deadlines, cancellation e propagação de failure semantics
Retry sem classificação de erro é amplificação de falha. Quando uma dependência começa a degradar, clientes agressivos aumentam carga justamente no momento em que o sistema possui menos capacidade. Por isso, retries precisam ser tratados como orçamento, não como reação automática.
Erros transitórios podem ser repetidos; validação, autorização e invariantes de negócio normalmente não devem ser. O servidor deve retornar uma taxonomia capaz de diferenciar retryable de terminal failure. O client runtime precisa respeitar essa semântica.
Exponential backoff reduz sincronização, mas jitter é necessário para evitar retry storms. Além disso, cada tentativa deve consumir um deadline global. Um workflow com budget de oito segundos não pode executar três chamadas de cinco segundos em sequência apenas porque cada componente possui timeout próprio.
Deadline propagation é mais importante que timeout local. O backend precisa saber quanto tempo resta para evitar trabalho cujo resultado já não poderá ser consumido.
Cancellation também precisa atravessar a cadeia. Cancelar a chamada MCP não significa automaticamente cancelar uma operação já submetida ao backend. Quando cancellation forte não é possível, o contrato deve distinguir cancel requested de cancelled.
A revisão atual do MCP introduziu mecanismos mais adequados ao core stateless e a interações multi-round-trip, mas implementação de cancellation e recuperação ainda precisa respeitar a realidade do sistema downstream.
Failure semantics deveriam ser preservadas até o agente sem expor detalhes irrelevantes. Uma resposta pode indicar unavailable, conflict, denied ou deadline exceeded.
O princípio é evitar retries cegos produzidos pelo próprio LLM. Retry policy pertence ao runtime porque precisa ser determinística, observável e consistente. O modelo pode decidir estratégia de negócio após uma falha; ele não deveria reinventar mecanismos básicos de resiliência a cada chamada.
4.3. Tasks assíncronas, checkpoints e recuperação de execuções distribuídas
Nem todo trabalho cabe em uma chamada síncrona. Processamento de documentos, geração de artefatos, deployment, análise de datasets e workflows empresariais podem durar minutos ou horas. Manter uma conexão aberta durante todo esse período cria dependência desnecessária entre duração lógica e transporte.
Tasks permitem representar trabalho com identidade, status e lifecycle próprios. A extensão MCP para Tasks fornece uma linguagem padronizada para iniciar e acompanhar operações long-running. Entretanto, uma task identifier não é, por si só, uma garantia de durabilidade. O runtime ainda precisa persistir o estado necessário para reconstruir a execução após falhas.
Checkpointing deve ocorrer em boundaries semanticamente seguros. Persistir depois de cada linha de código é caro e pouco útil; persistir após uma ação irreversível permite recovery consistente. O checkpoint precisa registrar não apenas “etapa 4”, mas outputs, side effects confirmados, idempotency keys e versão do workflow.
Ownership também importa. Em execução distribuída, workers podem morrer. Leases ou heartbeats ajudam a detectar abandono sem permitir que dois workers executem simultaneamente a mesma etapa.
Tasks deveriam separar status operacional de resultado de negócio. “Completed” significa que o runtime terminou; não necessariamente que o objetivo do agente foi atingido. Evaluation posterior pode determinar task success.
Cancelamento de tasks também possui semântica própria. Algumas operações podem ser interrompidas; outras só podem receber uma solicitação de compensação.
A combinação de durable execution com MCP cria uma fronteira útil: o agente descreve intenção e acompanha progresso, enquanto o workflow engine garante persistência.
Para Staff Engineers, a escolha importante é não colocar durabilidade dentro do LLM loop. Raciocínio pode ser efêmero; efeitos e progresso operacional precisam sobreviver a processos, deploys e falhas.
4.4. Backpressure, circuit breakers, bulkheads e graceful degradation entre dependências
Agentes podem gerar padrões de carga diferentes de aplicações tradicionais. Um único objetivo pode produzir fan-out para múltiplas tools, retries adicionais e chamadas recursivas. Quando milhares de agentes executam simultaneamente, pequenas variações de comportamento do modelo podem se transformar em grandes variações de tráfego.
Backpressure impede que demanda ilimitada atravesse a arquitetura. Rate limits controlam frequência; admission control decide se novo trabalho deveria entrar; bounded queues limitam backlog. Quando capacidade termina, rejeitar cedo pode ser mais seguro que aceitar trabalho que violará todos os deadlines.
Circuit breakers protegem dependências degradadas. Entretanto, devem operar por failure domain correto. Um breaker global para todo MCP server pode derrubar capabilities saudáveis porque uma única integração falhou. Granularidade por tool ou backend geralmente produz isolamento melhor.
Bulkheads limitam compartilhamento de recursos. Pools separados para operações críticas impedem que uma tool lenta consuma todas as conexões ou workers. Multi-tenancy pode exigir quotas de concorrência para evitar noisy neighbors.
Graceful degradation precisa ser semântica. Se uma fonte secundária está indisponível, um agente pode continuar com confidence menor. Se o sistema responsável por autorização está indisponível, fail-open provavelmente é inadequado. Cada dependency precisa de uma estratégia alinhada ao risco.
Load shedding também deveria preservar trabalho de maior valor. Priority queues podem diferenciar tráfego interativo, batch e operações administrativas.
Observability fecha o ciclo. Saturação, queue time e rejected requests precisam aparecer antes de error rate aumentar.
O objetivo não é eliminar overload. É controlá-lo. Infraestrutura agentic confiável precisa permanecer previsível quando o modelo produz mais trabalho do que o planejado. Em distributed AI systems, capacidade também é uma policy boundary: nenhuma decisão inteligente compensa uma plataforma que aceita mais trabalho do que consegue executar.
5. Observability e Evaluation: medindo comportamento, qualidade e confiabilidade do sistema
Observability em MCP precisa conectar dois mundos que historicamente são medidos separadamente: software determinístico e decisão probabilística. Métricas tradicionais mostram latência, erros e CPU. LLM evaluation mede qualidade, groundedness ou task success. Em sistemas agentic, nenhum dos dois conjuntos isoladamente explica por que uma tarefa falhou.
Uma execução pode retornar HTTP 200 e ser semanticamente incorreta. O agente pode escolher a tool errada, construir argumentos válidos para o objetivo errado ou interpretar corretamente uma resposta desatualizada. Portanto, o telemetry model precisa representar intenção, decisão, execução e efeito.
Traces devem correlacionar model calls, tool selection, MCP requests, downstream calls e side effects. A especificação atual documenta propagação de W3C Trace Context em metadata, o que facilita integração com ecossistemas OpenTelemetry e observabilidade distribuída.
Entretanto, observability não substitui evaluation. Telemetry responde o que aconteceu; evaluation determina se o comportamento foi adequado. A plataforma precisa transformar traces em datasets para regressão, incident analysis e comparação entre versões.
Isso também muda SLO design. Availability de um MCP server pode permanecer em 99,99% enquanto task success despenca devido a descrição ambígua de tools. Por isso, SLOs técnicos e métricas de qualidade precisam coexistir.
Custo deve aparecer no mesmo trace. Tokens, tool calls, retries e tempo de execução precisam ser atribuídos à tarefa original.
Para Staff e Principal Engineers, esse é um ponto central: qualidade agentic é uma propriedade emergente da cadeia inteira. Medir apenas o modelo ou apenas a infraestrutura cria observabilidade incompleta. A unidade real de análise deve ser a execução end-to-end.
5.1. Distributed tracing da decisão do agente ao side effect no sistema de destino
Um trace de produção útil precisa começar antes da chamada MCP. Se a observabilidade começa no gateway, perde-se justamente a informação necessária para explicar por que aquela capability foi escolhida. O root span deveria representar a tarefa ou execução agentic, não apenas uma requisição HTTP.
Subspans podem representar model inference, retrieval, planning, tool selection, MCP transport, server execution e chamadas downstream. O objetivo não é registrar chain-of-thought, mas capturar decisões observáveis: tool escolhida, versão, argumentos normalizados, policy decision, latency e resultado.
Trace context precisa atravessar os boundaries. A padronização recente de campos associados a W3C Trace Context ajuda clientes, servidores e gateways a correlacionar chamadas no mesmo span tree.
Side effects merecem atributos próprios. Se uma tool criou um ticket ou pagamento, o trace deveria armazenar um identificador seguro do efeito produzido. Isso permite reconciliar casos em que o cliente sofreu timeout, mas a operação terminou.
Cardinality precisa ser controlada. Tool name pode ser label; prompt completo ou user input não deveria virar dimensão de métrica. Dados sensíveis também precisam de redaction antes de traces deixarem o runtime.
Sampling tradicional pode perder justamente execuções raras e caras. Tail-based sampling permite preservar traces com erro, alta latência ou políticas sensíveis.
Tracing também pode alimentar evaluation. Execuções reais podem ser convertidas em casos de replay após anonimização adequada.
Um Staff Engineer deveria conseguir selecionar uma tarefa fracassada e responder: qual modelo decidiu, qual capability selecionou, qual policy autorizou, qual instância executou, qual backend respondeu e qual efeito foi produzido. Se essa cadeia não pode ser reconstruída, a plataforma ainda não possui observabilidade suficiente para operar autonomia em escala.
5.2. SLIs, SLOs e error budgets por tool, MCP server, tenant e dependência
Definir um único SLO para “MCP availability” é quase inútil. Um servidor pode expor dez tools com perfis completamente diferentes. Uma pode executar leitura de cache em 20 ms; outra depende de um sistema externo com latência de segundos. Agregar ambas esconde problemas e produz decisões operacionais incorretas.
SLIs deveriam ser definidos por camada. No transporte, success rate, latency e saturation importam. No nível da tool, execution success, timeout rate e queue time fornecem sinal melhor. No nível do workflow, task completion e end-to-end latency representam a experiência real.
Tenant também pode ser uma dimensão operacional, principalmente quando existe risco de noisy neighbor. Entretanto, métricas de alta cardinalidade exigem estratégia de aggregation para não tornar observability financeiramente inviável.
SLO deve refletir expectativa do consumidor. Uma tool crítica usada em um fluxo síncrono pode precisar de p99 rigoroso. Uma operação batch pode tolerar minutos desde que complete dentro de uma janela.
Error budgets transformam reliability em mecanismo de governança. Se uma capability consome orçamento rapidamente, novos rollouts podem ser bloqueados. Essa automação reduz discussões subjetivas durante incidentes.
Dependencies precisam ser associadas ao mesmo modelo. Se a tool depende de três APIs, o SLO composto nunca será melhor que a combinação delas. Esse cálculo influencia arquitetura e vendor selection.
Além de erro técnico, pode existir semantic error budget. Se alterações de descrição reduzem tool selection accuracy, a plataforma pode tratar isso como regressão mesmo sem aumento de HTTP errors.
O objetivo é conectar confiabilidade ao valor do workflow. SLO não é dashboard decorativo. É um contrato operacional que ajuda Staff Engineers a decidir onde investir redundância, onde aceitar degradação e quando reduzir velocidade de mudança.
5.3. Evaluation de tool selection, argument generation, execution correctness e task success
Evaluation de MCP precisa decompor o problema. Medir apenas resposta final torna difícil localizar regressões. Uma execução pode falhar porque o agente selecionou a tool errada, porque gerou argumentos incorretos, porque a implementação retornou dados ruins ou porque interpretou mal um resultado correto.
Tool selection evaluation mede se a capability escolhida corresponde à intenção. Datasets devem incluir hard negatives: tools semanticamente próximas que forçam discriminação real. Accuracy simples pode ser insuficiente quando múltiplas ferramentas são aceitáveis; ranking metrics podem capturar qualidade do candidate set.
Argument generation avalia schema adherence e semantic correctness. Um valor pode validar contra JSON Schema e ainda estar errado para o contexto. Testes precisam comparar entidades, unidades, datas, identifiers e invariantes relevantes.
Execution correctness pertence ao MCP server e aos sistemas downstream. Contract tests verificam formatos; integration tests verificam comportamento; property-based tests ajudam a explorar combinações inesperadas.
Task success mede o objetivo end-to-end. Essa métrica pode exigir regras determinísticas, human review ou LLM-as-judge cuidadosamente calibrado. Em ações críticas, efeitos observáveis no sistema de registro são referência melhor que texto final.
Evaluation também precisa medir abstention. Um agente que chama uma tool quando deveria solicitar informação adicional pode ser mais perigoso que um agente que erra um parâmetro recuperável.
Offline e online evaluation se complementam. Benchmarks permitem comparação reprodutível; produção revela distribuição real.
A arquitetura ideal liga cada failure case ao trace correspondente. Assim, uma queda de task success pode ser atribuída a modelo, prompt, tool contract ou backend.
Esse nível de decomposição transforma evaluation em engenharia. Em vez de perguntar “o agente ficou pior?”, a equipe consegue identificar qual etapa alterou comportamento e quais mudanças devem ser revertidas.
5.4. Contract tests, shadow traffic, canary releases, fault injection e regressão contínua
MCP servers deveriam possuir pipeline de validação semelhante ao de serviços críticos, mas com uma camada adicional de behavioral regression. Unit tests não são suficientes porque a interface participa do raciocínio do modelo.
Contract tests validam schemas, required fields, error taxonomy, metadata e invariantes. Consumer-driven contracts podem verificar expectativas específicas de hosts importantes. Entretanto, contratos estáticos não detectam mudanças de tool selection causadas por novas descrições.
Shadow traffic resolve parte desse problema. Traces reais podem ser reproduzidos contra uma nova versão sem permitir side effects. A implementação candidate recebe a mesma intenção e seus resultados são comparados com a versão atual.
Canary release adiciona tráfego real progressivamente. O rollout deve observar não apenas errors e latency, mas task success, retry amplification e custo por execução. Uma versão que reduz latência mas duplica chamadas pode ser regressão econômica.
Fault injection testa comportamento sob partial failure. Latência artificial, timeouts, malformed responses e dependency outages mostram se o runtime respeita deadlines e circuit breakers.
Chaos testing precisa ser seletivo em integrações com side effects. Simular falha depois do commit é particularmente valioso para validar idempotency.
Regressão contínua deve combinar sinais. Mudanças em servidor, description, schema, gateway policy ou modelo podem afetar o sistema. Pipelines que avaliam apenas código do MCP server deixam dependências invisíveis.
Uma prática madura mantém um golden corpus de intents, traces anonimizados e edge cases adversariais. Cada release é comparado contra baselines técnicos e semânticos.
O princípio é tratar comportamento agentic como parte do contrato de produção. Se uma mudança altera significativamente como agentes usam uma capability, ela merece a mesma disciplina aplicada a uma breaking API change.
6. Performance e Economics: escala, latência e custo em infraestruturas MCP distribuídas
Performance em sistemas agentic não pode ser analisada apenas por latência de uma chamada individual. O custo real emerge da composição: model inference, retrieval, tool discovery, chamadas MCP, dependências downstream, retries e novas inferências produzidas pelos resultados. Um hop adicional de 50 ms pode parecer irrelevante, mas multiplicado por fan-out e loops sequenciais torna-se parte significativa do critical path.
O mesmo vale para custo. Uma tool barata pode produzir uma resposta grande que aumenta tokens na próxima inferência. Um catálogo excessivo pode elevar prompt size. Retries podem multiplicar custos de terceiros. Observability pode gerar grande volume de telemetry. Economics precisa ser modelado end-to-end.
Performance engineering começa pela decomposição da latência. É necessário saber quanto tempo está em queueing, network, policy evaluation, execution e downstream services. Sem isso, otimizações tendem a atacar o componente mais visível, não o gargalo real.
MCP stateless ajuda horizontal scaling porque reduz dependência de affinity em requisições comuns. Cache hints introduzidos na especificação atual também permitem diminuir listagens redundantes. Porém, cada otimização cria trade-offs de freshness, consistência e complexidade.
Capacity planning deve considerar burstiness. Agents podem produzir fan-out dinâmico, o que torna averages pouco representativos. Concurrency, p95 fan-out e retry factor são variáveis mais úteis.
Economics também deve influenciar architecture. Nem toda capability merece execução imediata ou modelo premium. Admission control, batching e routing podem otimizar custo sem reduzir qualidade.
Para Staff Engineers, performance e custo não são fases posteriores de otimização. Eles são propriedades estruturais. Uma arquitetura que depende de dezenas de hops sequenciais dificilmente será corrigida por tuning local.
6.1. Latency budgets, fan-out, critical path e amplificação de latência em workflows agentic
Latency budget precisa começar no objetivo do usuário e ser decomposto para trás. Se uma interação precisa responder em cinco segundos, esse tempo deve ser distribuído entre inference, retrieval, tool execution e geração final. Permitir que cada componente escolha seu próprio timeout produz uma soma impossível.
Fan-out complica esse cálculo. Chamadas paralelas reduzem latência comparadas à execução sequencial, mas o tempo total passa a depender da tail latency do ramo mais lento. Se dez tools são chamadas em paralelo, o workflow frequentemente espera a mais lenta, não a média.
Critical path analysis ajuda a identificar quais operações realmente determinam duração. Otimizar uma tool fora do caminho crítico pode não produzir nenhum efeito perceptível.
Loops agentic introduzem amplificação adicional. Uma redução pequena na latência de cada tool pode ter grande impacto quando a operação ocorre em seis ciclos. Por outro lado, adicionar um validation hop a cada iteração pode destruir o orçamento total.
Deadlines deveriam ser propagados dinamicamente. Uma tool iniciada quando restam 800 ms não deveria receber timeout padrão de cinco segundos. O runtime pode ajustar comportamento ou escolher uma alternativa mais rápida.
Hedged requests são úteis apenas em operações idempotentes e de leitura; caso contrário, podem duplicar side effects. Speculative execution também precisa considerar custo.
Latency observability deve separar server processing de queue time. Em overload, o gargalo frequentemente é espera, não execução.
Uma prática avançada é manter latency profiles por capability e utilizar esses dados no planner. Se duas tools oferecem informação equivalente, o sistema pode selecionar com base em deadline e confidence.
A conclusão é que latência se torna parte da semântica de decisão. Em AI Engineering de produção, “qual ferramenta usar?” pode depender não apenas de relevância, mas do tempo restante para cumprir o SLO.
6.2. Caching, connection management e redução de chamadas sem comprometer consistência semântica
Caching em MCP precisa considerar dois tipos de freshness: técnica e semântica. Um catálogo de tools pode permanecer estruturalmente válido por minutos, enquanto um resource ligado a preço ou disponibilidade pode expirar em segundos. Aplicar a mesma política a ambos cria either desperdício ou stale data.
A especificação 2026-07-28 introduziu ttlMs e cacheScope para operações cacheáveis, permitindo que servidores comuniquem duração e compartilhamento permitido. Isso melhora eficiência, mas não elimina responsabilidade arquitetural: o servidor ainda precisa escolher TTL coerente com a volatilidade do dado.
Cache de discovery reduz overhead e estabiliza prompt construction. Se a lista de tools não muda frequentemente, refazê-la a cada interação consome latência e capacidade sem benefício.
Resultados de leitura podem utilizar cache por tenant ou usuário quando autorização permite. Entretanto, cache keys precisam incluir dimensões que afetam resposta. Ignorar locale, permission scope ou model version pode produzir data leakage ou comportamento inconsistente.
Invalidation continua sendo difícil. Event-driven invalidation melhora freshness, mas adiciona infraestrutura. TTL simples é mais robusto, porém aceita janela de stale data.
Connection management também importa. Reusar conexões HTTP reduz handshake overhead; pools precisam ser dimensionados para concorrência e long-lived operations. Head-of-line blocking e limites do upstream devem fazer parte da análise.
Outra otimização é evitar chamadas redundantes dentro da mesma execução. Um per-run memoization layer pode reutilizar resultados determinísticos.
Contudo, cache não deve mascarar side effects. Operações mutáveis precisam de semântica própria.
O princípio é otimizar repetição previsível sem esconder mudança importante. Caching bem projetado reduz latência, custo e carga; caching ingênuo transforma eficiência em fonte silenciosa de erro semântico.
6.3. Rate limits, quotas, admission control e capacity planning para workloads imprevisíveis
Rate limiting responde “quanto por unidade de tempo”; admission control responde “devemos aceitar este trabalho agora?”. Em sistemas agentic, ambos são necessários porque número de chamadas por objetivo pode variar de forma significativa.
Quotas deveriam existir em múltiplas dimensões: tenant, user, agent, tool, provider e risk class. Uma quota global protege infraestrutura, mas não impede que um consumidor monopolize capacidade. Hierarchical quotas permitem reservar recursos para workloads críticos.
Token bucket funciona bem para bursts controlados. Concurrency limits são mais adequados para operações longas. Queue limits evitam backlog infinito. A combinação depende do perfil da capability.
Admission control pode considerar mais que capacidade atual. Deadline, estimated cost e priority podem influenciar decisão. Uma tarefa batch que não terminará dentro de sua janela pode ser rejeitada antes de consumir recursos.
Capacity planning precisa modelar amplification factor. Se cada user request gera em média três model calls e quatro tool calls, escalar usuários em 2x não implica apenas 2x no gateway. Loops e retries podem produzir crescimento maior.
Percentis são mais úteis que média. O p99 de fan-out pode determinar sizing mesmo quando a maioria das tarefas é simples. Simulações com traces históricos ajudam a estimar picos.
Autoscaling também possui atraso. Workers podem aumentar em minutos enquanto agent bursts surgem em segundos. Pré-aquecimento e queue buffers podem absorver parte dessa diferença.
Quotas devem ser observáveis pelo planner. Se uma capability está saturada, o agente pode escolher alternativa ou reduzir paralelismo.
Esse desenho transforma capacity management em parte do runtime. Em vez de descobrir sobrecarga através de timeouts, a plataforma passa a controlar entrada explicitamente. Para workloads agentic, previsibilidade de capacidade é um requisito de confiabilidade, não apenas uma preocupação de infraestrutura.
6.4. Modelando o custo total: tokens, tool calls, infraestrutura, egress, observabilidade e retries
Custo de MCP não é apenas infraestrutura do servidor. O Total Cost of Execution inclui tokens de entrada e saída, model calls, tool calls, compute, storage, database operations, SaaS APIs, network egress, observability, retries e intervenção humana.
Uma arquitetura pode reduzir custo do LLM e aumentar custo total. Por exemplo, adicionar várias tools ao contexto pode elevar prompt size em todas as inferências. Utilizar um modelo barato que escolhe ferramentas com menor precisão pode gerar retries e chamadas externas caras.
Por isso, custo precisa ser atribuído ao nível da tarefa. Unit economics úteis incluem custo por successful task, custo por capability, custo por tenant e custo por tipo de workflow. Custo por chamada isolada oferece pouca informação quando uma execução precisa de vinte chamadas.
Retries merecem linha própria. Um retry factor de 1,15 significa 15% de trabalho adicional em todos os componentes envolvidos. Em escala, isso pode superar o custo de uma otimização de modelo.
Observability também precisa de budget. Full-fidelity traces com payloads grandes podem custar mais que o próprio runtime de tools. Sampling e tiered retention equilibram forensic value e custo.
Egress se torna importante quando MCP servers conectam regiões ou clouds diferentes. Data locality pode ser economicamente tão relevante quanto latência.
Cost-aware routing pode selecionar providers ou implementations com base em preço, desde que preserve SLO e qualidade.
Uma métrica especialmente útil é marginal cost of reliability. Quanto custa elevar uma capability de 99,9% para 99,99%? Essa resposta orienta redundância.
Staff Engineers deveriam tratar economics como restrição arquitetural mensurável. O objetivo não é minimizar custo absoluto. É maximizar task success e valor entregue dentro de um envelope econômico sustentável.
7. Operating Model: governança e evolução de MCP como infraestrutura compartilhada
Quando MCP se transforma em infraestrutura compartilhada, tecnologia deixa de ser o único problema. Surge a necessidade de um operating model que defina ownership, lifecycle, risk management e responsabilidades entre platform teams e equipes de domínio.
Centralizar tudo reduz inconsistência, mas cria gargalo organizacional. Descentralizar completamente acelera onboarding, porém multiplica padrões incompatíveis. O modelo mais sustentável costuma combinar plataforma central com ownership federado.
A equipe de plataforma fornece SDKs, templates, policy enforcement, registry, observability, security primitives e pipelines de conformance. Equipes de domínio continuam responsáveis pela semântica de suas capabilities, SLOs e impactos nos sistemas de negócio.
Governança deve ser proporcional ao risco. Uma tool read-only sobre documentação interna não precisa do mesmo processo de uma tool capaz de emitir pagamentos. Risk tiers permitem acelerar casos seguros e concentrar revisão onde falhas possuem maior impacto.
Change management precisa incluir tool contracts. Alterar descrição, schema ou side-effect semantics pode afetar agentes mesmo quando APIs internas permanecem estáveis.
O operating model também define incident response. Quem possui autoridade para desabilitar uma tool? Quem decide rollback? Como agentes descobrem que uma capability está temporariamente indisponível?
A infraestrutura precisa incluir mecanismos técnicos para responder a essas perguntas, não apenas documentos organizacionais.
Outro ponto é vendor governance. MCP reduz custo de integração com terceiros, mas facilidade de conexão não elimina due diligence. External servers precisam de avaliação de segurança, data handling e reliability.
Para Principal Engineers, essa camada é decisiva. Arquitetura não termina quando componentes funcionam. Ela precisa continuar funcionando enquanto dezenas de equipes fazem mudanças simultaneamente. Um bom operating model transforma padrões técnicos em capacidade organizacional escalável.
7.1. Ownership, onboarding e certificação de MCP servers internos e de terceiros
Todo MCP server deveria ter um owner claramente identificável. Sem ownership, incidentes viram investigações sobre quem conhece o código, deprecações nunca terminam e vulnerabilidades permanecem sem responsável. Registry metadata precisa tornar ownership uma propriedade obrigatória.
Onboarding deve ser self-service para reduzir gargalos, mas não sem guardrails. Templates podem incluir autenticação, tracing, health checks, timeout handling e error taxonomy por padrão. CI valida schemas, naming conventions, security configuration e documentação antes da publicação.
Certification pode operar por níveis. Um servidor experimental pode ficar restrito a ambientes internos de teste. Uma capability production-ready precisa cumprir SLO, evaluation e incident response requirements. Ferramentas com side effects críticos exigem controles adicionais.
Conformance técnica ao MCP é apenas uma parte da certificação. Também importa verificar semantic quality. Descrições são claras? Argumentos possuem constraints adequadas? Outputs são bounded? Existe informação suficiente para o modelo decidir corretamente?
Servidores de terceiros precisam de uma trilha diferente. Além de interoperability, devem ser avaliados quanto a data retention, authorization, availability, incident disclosure e supply-chain risk. Uma integração simples do ponto de vista do protocolo pode continuar sendo complexa do ponto de vista de governança.
Ownership também deve incluir custos. Equipes precisam enxergar consumo e crescimento associados às suas capabilities.
Deprecation exige responsabilidade dos dois lados. Producer anuncia prazo; consumers recebem telemetry indicando dependência.
Esse modelo cria accountability sem eliminar autonomia. A plataforma não revisa manualmente cada linha, mas define condições verificáveis para participação no ecossistema.
O objetivo é transformar criação de MCP servers em paved road. O caminho seguro e observável deve ser o mais fácil. Quando a plataforma consegue isso, governance deixa de ser burocracia e passa a funcionar como multiplicador de velocidade.
7.2. Policy as Code, auditabilidade e governança por níveis de risco operacional
Policies escritas apenas em documentos não conseguem acompanhar decisões executadas milhares de vezes por minuto. Em uma plataforma MCP, requisitos críticos precisam ser convertidos em Policy as Code sempre que puderem ser avaliados deterministicamente.
Uma policy pode combinar identidade, tool, arguments, tenant, data classification, região, risk tier e workflow state. A decisão resultante pode ser allow, deny, require approval ou route to restricted execution.
Centralizar policy logic melhora consistência, mas o policy engine não deve virar dependência frágil. Decisões cacheáveis, compiled policies e estratégias fail-closed para operações sensíveis reduzem risco durante indisponibilidade.
Auditabilidade precisa registrar mais que “usuário X chamou tool Y”. Uma auditoria útil inclui actor, subject, agent identity, capability version, policy version, decision, relevant attributes e side-effect identifier. Isso permite reconstruir por que a ação foi autorizada.
Risk tiers simplificam governança. Capabilities read-only sobre dados públicos podem exigir controles leves. Acesso a PII demanda autorização e logging mais fortes. Operações financeiras irreversíveis podem exigir human approval e dual control.
Policy changes também precisam de rollout. Uma regra incorreta pode bloquear todo ecossistema. Shadow evaluation permite executar nova policy sem enforcement e medir impacto antes da ativação.
Policies deveriam ser testadas como código. Casos positivos, negativos e adversariais fazem parte do pipeline.
É importante manter autorização fora do LLM. O modelo pode fornecer contexto, mas não deve decidir sua própria permissão.
Esse modelo produz uma separação poderosa: agents mantêm flexibilidade para planejar; a plataforma mantém deterministic control sobre ação. Para AI Engineering enterprise, essa combinação é o que permite aumentar autonomia sem abandonar princípios clássicos de segurança e governança.
7.3. Rollouts, kill switches, rollback e incident response em ecossistemas agentic
Rollout de uma MCP capability precisa assumir que regressões podem ser técnicas ou comportamentais. Uma versão pode funcionar perfeitamente no nível HTTP e ainda induzir o agente a selecionar a tool errada. Por isso, deployment strategy deve combinar métricas tradicionais com evaluation.
Canary releases limitam exposure. Routing pode direcionar pequena fração de tráfego para nova versão e comparar task success, latency, errors e custo. Quando possível, segmentação por tenant interno reduz impacto inicial.
Kill switches precisam existir em diferentes níveis. É útil desabilitar um MCP server inteiro, mas frequentemente granularidade por tool reduz blast radius. Uma operação crítica comprometida pode ser bloqueada enquanto funções read-only permanecem disponíveis.
O kill switch deve atuar no Control Plane e ser propagado rapidamente. Não deveria depender de redeploy do servidor.
Rollback também precisa considerar schema e state. Se uma nova versão criou dados em formato diferente, voltar binário pode não ser suficiente. Migration strategy precisa fazer parte do rollout plan.
Incident response em sistemas agentic exige traces correlacionados. A equipe precisa identificar quais tarefas utilizaram a capability afetada e quais side effects foram produzidos. Isso permite remediation seletiva em vez de assumir que toda execução foi corrompida.
Containment pode incluir reduzir scopes, bloquear determinados argumentos ou redirecionar para implementação segura.
Runbooks devem considerar comportamento do agente após falha. Se uma tool desaparece, o modelo pode escolher alternativa inesperada. Portanto, graceful disablement também precisa ser avaliado.
Postmortems deveriam incluir dimensões semânticas: por que o agente continuou, qual fallback escolheu e por que policy permitiu.
A meta não é evitar incidentes. É tornar impacto limitado, diagnóstico rápido e recuperação reversível. Essa propriedade diferencia uma coleção de integrações de uma plataforma realmente operável.
7.4. Build versus buy e os trade-offs de operar MCP como uma Platform Engineering capability
A decisão entre construir uma plataforma MCP internamente ou adotar produtos de gateway, registry e governance precisa ser decomposta por capability. “Build versus buy MCP” é amplo demais. Uma empresa pode comprar observability, usar um identity provider existente e desenvolver internamente apenas semantic registry e policy integration.
Buy acelera time-to-market e transfere manutenção de componentes commodity. Entretanto, a camada escolhida pode se tornar parte do critical path de todas as execuções agentic. Latency, availability, pricing model e extensibility do fornecedor passam a ser atributos da arquitetura.
Build oferece controle sobre policy, metadata e integration patterns. O custo aparece em engineering headcount, on-call, security review, SDK maintenance e evolução do protocolo. Implementar um gateway é simples; operar um ecosystem control plane durante anos é outra categoria de investimento.
Vendor lock-in deve ser analisado no nível dos dados de controle. Se tool contracts, policies e traces ficam armazenados em formatos proprietários, migrar pode ser mais difícil que substituir o transporte.
Open standards reduzem parte desse risco, mas não eliminam operational coupling. MCP padroniza interação; não padroniza necessariamente todo registry, evaluation ou governance layer.
A decisão também depende de diferenciação. Se capability routing e agent governance são centrais para vantagem competitiva, construir componentes estratégicos pode fazer sentido. Se são infraestrutura indiferenciada, comprar pode reduzir custo total.
Uma abordagem Staff-level começa pelo operating model desejado e calcula TCO de três a cinco anos, incluindo pessoas e incidentes.
O objetivo não é maximizar código próprio. É preservar controle onde arquitetura exige diferenciação e terceirizar onde maturidade externa supera o valor de construir. MCP como Platform Engineering capability deve ser tratado como portfólio de decisões, não como uma escolha binária de produto.
Memory Engineering para AI Agents: arquitetura, persistência e controle semântico da memória
Da Janela de Contexto ao Context Runtime: Arquitetura, Evaluation e Economics de Context Engineering…
AI agents em produção: como projetar agent runtimes confiáveis para sistemas autônomos de longa…