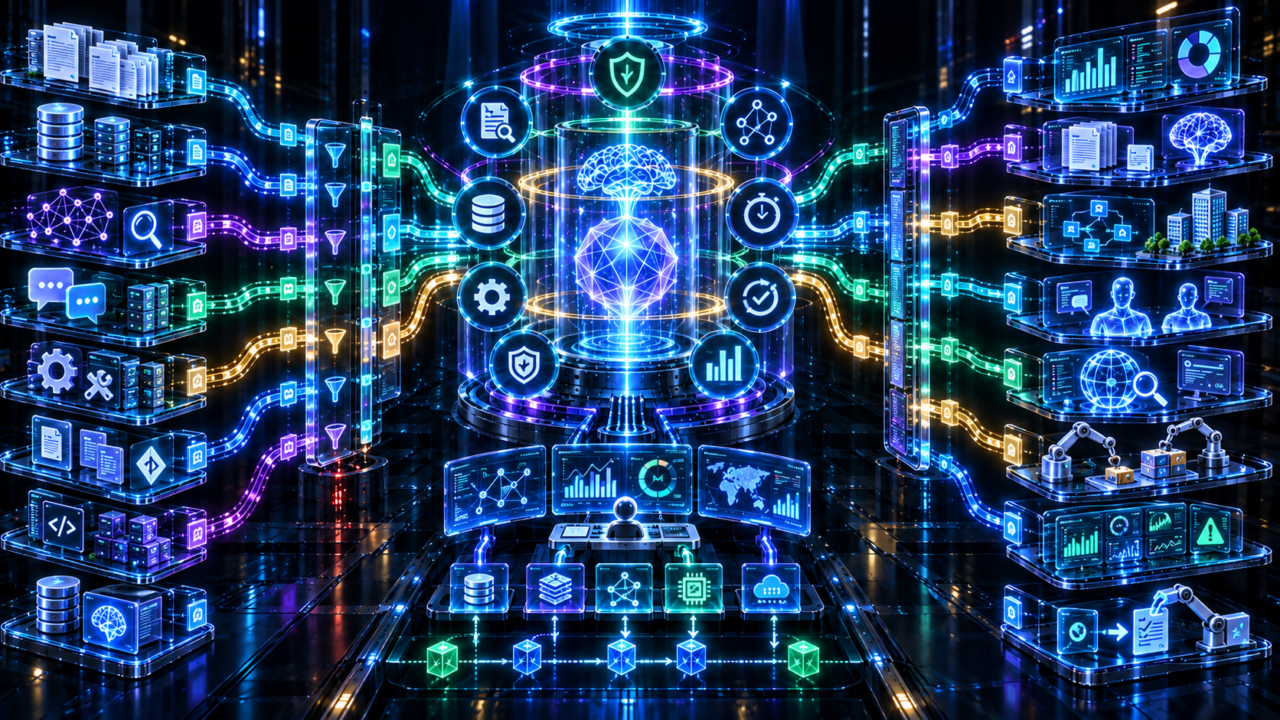
Context Engineering está se tornando uma disciplina central de AI Engineering porque sistemas baseados em LLMs deixaram de operar como funções quase estáticas de entrada e saída. Em aplicações de produção, o modelo recebe um estado informacional construído dinamicamente a partir de system instructions, histórico conversacional, retrieval, memória, tool outputs, estado de workflow, políticas, artifacts e informações obtidas durante a própria execução. A engenharia desse estado passa a determinar não apenas a qualidade da resposta, mas também latência, custo, segurança, confiabilidade e capacidade de executar tarefas longas.
Por isso, tratar uma context window grande como solução arquitetural é insuficiente. Contexto é um recurso computacional finito, com utilidade marginal variável. Adicionar tokens pode ampliar evidência disponível, mas também introduzir ruído, contradições, stale information e competition por attention. Trabalhos recentes sobre Context Engineering destacam justamente a necessidade de selecionar e manter conjuntos de tokens de alto sinal, em vez de simplesmente maximizar volume de informação.
Neste artigo, uso Context Runtime para representar uma camada arquitetural responsável por construir, governar, observar e evoluir o estado informacional apresentado ao modelo durante inference. Essa camada decide o que carregar, quando recuperar, quanto preservar, como compactar, quais informações descartar e quais boundaries de confiança aplicar.
A discussão, portanto, não será sobre escrever prompts melhores. O problema Staff-level é projetar uma infraestrutura capaz de transformar um universo potencialmente ilimitado de dados em um contexto pequeno, relevante, rastreável, seguro e economicamente eficiente para cada decisão executada por um sistema de AI.
Fale comigo no LinkedIn: https://www.linkedin.com/in/celso-sousa/
1. Context Engineering como problema de arquitetura, não de Prompt Engineering
Prompt Engineering atua principalmente sobre instruções. Context Engineering atua sobre o estado informacional completo utilizado durante inference. Essa diferença parece semântica, mas modifica profundamente a arquitetura. Em um sistema de AI Engineering maduro, o prompt é apenas uma das entradas de um pipeline responsável por selecionar evidências, reconstruir state, resolver dependências, consultar memória, materializar tool outputs e estabelecer políticas antes de cada chamada ao modelo.
Isso significa que contexto precisa ser tratado como um produto intermediário do sistema. Assim como um query planner transforma uma consulta lógica em um plano físico, um Context Runtime transforma intenção, estado e fontes de conhecimento em um contexto executável. O LLM não deveria receber tudo que está disponível. Deveria receber o menor conjunto de informações capaz de maximizar a probabilidade de uma decisão correta dentro das restrições de custo, latência e segurança.
Essa mudança também altera ownership. Prompt templates deixam de ser o principal ponto de controle. Retrieval pipelines, memory policies, caching, token budgets, authorization, context schemas, observability e evaluation passam a fazer parte do mesmo design system.
Em arquiteturas agentic, esse problema se repete em cada reasoning step. Uma execução de cinquenta tool calls pode produzir centenas de milhares de tokens intermediários, embora apenas uma pequena fração seja relevante para a decisão seguinte. Sistemas recentes de agentes de longa duração também tratam context management, tool use e persistência como componentes explícitos do harness, em vez de depender apenas de uma janela crescente.
O desafio arquitetural real é decidir continuamente o que o modelo precisa saber agora.
1.1. Contexto como recurso computacional finito: relevância, densidade informacional e attention budget
Token budget não deve ser confundido com context capacity. Um modelo aceitar centenas de milhares de tokens não implica que todos esses tokens tenham o mesmo valor operacional. Para AI Engineering, a variável relevante é information utility per token: quanto cada fragmento contribui para reduzir incerteza, restringir ações incorretas ou melhorar a decisão produzida pelo modelo.
Isso sugere modelar contexto como um problema de resource allocation. Cada fonte compete por espaço dentro de um budget finito. System instructions consomem tokens, memória consome tokens, exemplos consomem tokens, retrieval consome tokens e resultados de tools consomem tokens. A política correta não é necessariamente preencher a janela, mas maximizar densidade semântica respeitando dependências da tarefa.
Em produção, três propriedades tornam esse problema difícil. Primeiro, relevance é condicional ao estado atual: um documento crucial no passo quinze pode ser irrelevante no passo três. Segundo, redundância não é gratuita. Repetições aumentam custo e podem modificar atenção relativa entre evidências. Terceiro, informação correta pode se tornar nociva quando está stale ou fora do domínio operacional da decisão corrente.
Um Context Runtime deveria, portanto, trabalhar com budgets explícitos. Parte do espaço pode ser reservada para instructions e safety policies; outra para state; outra para evidências recuperadas; outra para working memory e tool results. Esses budgets podem ser adaptativos conforme task complexity, confidence e remaining horizon.
A janela de contexto, nessa visão, deixa de ser armazenamento. Ela se aproxima de uma cache de alta prioridade para informação imediatamente necessária ao próximo inference step. Informação persistente pertence a stores externos; informação contextualizada pertence ao runtime apenas enquanto sua utilidade justificar o custo.
1.2. Do prompt estático ao contexto dinâmico: estado, evidências, memória, tools e políticas em runtime
Em aplicações simples, é possível representar inference como uma função aproximadamente estática: instruction mais user input entram no modelo e uma resposta é produzida. Em sistemas agentic, essa abstração quebra rapidamente. O conteúdo que precisa chegar ao modelo depende do estado construído por passos anteriores e das informações descobertas durante a própria execução.
Considere um AI agent responsável por investigar uma anomalia financeira. O primeiro inference step pode exigir apenas políticas operacionais, descrição da tarefa e identificadores. Após consultas a bancos de dados, o contexto passa a precisar de transações específicas. Depois de uma análise estatística, apenas alguns aggregates e outliers permanecem relevantes. Caso um segundo agente seja acionado, parte desse material precisará ser transformada em um handoff compacto. O contexto muda de forma contínua.
Esse comportamento exige separar context source de context materialization. Bancos, vector stores, object stores, graph databases, APIs e memória persistente representam fontes potenciais. O Context Runtime decide quais informações dessas fontes serão efetivamente materializadas em tokens no próximo inference step.
O runtime também precisa considerar políticas. Um dado pode existir e ser relevante, mas não estar autorizado para aquele tenant ou agente. Um tool output pode ser confiável, enquanto conteúdo externo recuperado da Web deve entrar em uma trust boundary distinta. Histórico conversacional pode conter instruções conflitantes com o system policy.
Context Engineering passa, assim, a operar sobre múltiplas dimensões simultâneas: relevance, authority, freshness, provenance, cost e security. O prompt final torna-se apenas a serialização temporária dessas decisões. O ativo arquitetural importante não é o template que formata o contexto, mas o mecanismo que decide quais informações merecem chegar até ele.
1.3. Context lifecycle: aquisição, seleção, transformação, composição, consumo e descarte
Um erro recorrente em arquiteturas de LLM é considerar contexto apenas no instante anterior à chamada ao modelo. Em produção, contexto possui lifecycle próprio. Cada informação nasce em uma fonte, atravessa transformações, recebe metadata, pode ser reutilizada em múltiplos reasoning steps e eventualmente precisa ser descartada, invalidada ou persistida fora da context window.
A primeira etapa é aquisição. Informações podem surgir do usuário, retrieval, tools, memória, APIs ou agentes especializados. Em seguida ocorre seleção, quando políticas determinam relevance, permissões e priority. Depois vem transformação: documentos podem ser chunked, resumidos, normalizados, reranked ou convertidos para formatos estruturados. Somente então ocorre composição, quando cada fragmento recebe posição, precedência e representação dentro do contexto.
Após inference, o lifecycle continua. O runtime precisa saber quais fragments foram efetivamente utilizados, quais novas informações surgiram e o que deve sobreviver ao próximo passo. Um resultado de SQL com dez mil linhas talvez seja necessário apenas durante análise; o aggregate final pode ser persistido como artifact e o resultado bruto removido da working context.
Esse lifecycle exige garbage collection semântico. Contexto que perdeu utilidade deve sair antes que se transforme em dívida cognitiva para o modelo. Entretanto, eviction agressiva pode remover detalhes que se tornarão importantes posteriormente. Por isso, descarte deve considerar recoverability: informações facilmente recuperáveis podem ser removidas cedo; decisões irreversíveis ou fatos difíceis de reconstruir merecem retenção maior.
A arquitetura resultante se aproxima menos de um prompt builder e mais de um memory manager. Ela controla materialização, permanência e remoção de informação com base na execução do sistema.
1.4. Failure modes além do context overflow: context rot, interference, contradiction e attention dilution
Context overflow é o failure mode mais visível, mas raramente é o mais perigoso. Sistemas podem permanecer abaixo do limite nominal da context window e ainda sofrer degradação substancial porque o problema não está apenas na quantidade de tokens. Está na estrutura informacional entregue ao modelo.
Context rot descreve a perda gradual de efetividade à medida que o contexto cresce e informações relevantes passam a competir com material secundário. Estudos e observações de sistemas de agentes indicam que context windows maiores não eliminam esse problema; por isso, compaction, resets e external memory aparecem em arquiteturas de longa duração.
Interference ocorre quando fragmentos individualmente corretos induzem comportamentos conflitantes quando combinados. Um policy document pode definir uma regra geral enquanto outro descreve uma exceção sem indicar precedência. Contradiction é ainda mais explícita: fontes diferentes apresentam valores incompatíveis para a mesma entidade.
Attention dilution ocorre quando evidências cruciais representam uma fração pequena do contexto total. Mesmo que a informação necessária esteja presente, sua influência sobre a geração pode diminuir. Esse failure mode é particularmente relevante em RAG pipelines que retornam muitos chunks para compensar recall baixo.
Há ainda temporal contamination. Dados antigos continuam semanticamente semelhantes à consulta e sobrevivem ao retrieval, embora já tenham sido substituídos. Tool outputs também podem permanecer depois que o estado externo mudou.
Esses problemas exigem mecanismos diferentes de simplesmente aumentar context window. Deduplication, temporal filtering, source authority, contradiction detection, reranking, pruning e explicit precedence precisam fazer parte do Context Runtime. A métrica correta deixa de ser “quantos tokens cabem” e passa a ser “qual informação continua justificando sua presença”.
2. Context Runtime: uma arquitetura de referência para sistemas de AI em produção
Context Runtime pode ser entendido como a infraestrutura responsável por transformar contexto potencial em contexto executável. Ele fica entre o universo de informação disponível para uma aplicação e o LLM chamado em cada reasoning step. Sua função é decidir quais dados devem atravessar essa fronteira, sob quais políticas e com qual representação.
Uma arquitetura madura pode dividir esse problema em três planos. O Data Plane contém informações e artifacts: documentos, memória, embeddings, resultados de tools, eventos, arquivos e estado persistido. O Control Plane contém políticas: token budgets, autorização, retention, source priority, freshness e constraints. O Context Plane executa as decisões necessárias para recuperar, transformar, organizar e serializar informação para inference.
Dentro desse runtime, componentes especializados tornam-se úteis. Um Context Router determina quais fontes consultar. Um Context Planner define a estratégia de materialização. Um Retriever obtém candidatos. Um Context Processor executa reranking, compression e normalization. Um Context Assembler produz a representação final. Context Stores preservam informação reutilizável. Observability registra decisões, provenance e custos.
Esse desenho não precisa existir como microsserviços separados. Em muitos casos, uma biblioteca dentro do Agent Runtime é suficiente. A abstração lógica, porém, é importante porque permite separar políticas de contexto do código de negócio.
O benefício maior aparece na evolução. Quando um novo modelo oferece context window maior, o sistema não precisa substituir disciplina arquitetural por brute force. Quando custos mudam, budgets podem ser recalibrados. Quando surgem novas fontes, elas entram por contratos definidos.
Context Runtime transforma Context Engineering de heurística de prompt em infraestrutura governável, testável e evolutiva.
2.1. Context Plane, Control Plane e Data Plane: separando decisão, armazenamento e execução
Separar Data Plane, Control Plane e Context Plane evita um problema comum em sistemas de AI: misturar dados, políticas e materialização em uma única função que concatena strings. Essa separação cria boundaries arquiteturais capazes de sobreviver ao crescimento do sistema.
O Data Plane concentra informação potencialmente consumível. Isso inclui vector databases, relational databases, graph stores, object storage, message histories, feature stores, APIs, artifacts e memory stores. O fato de um dado existir no Data Plane não significa que ele deva aparecer na context window. Ele apenas está disponível para consulta.
O Control Plane define as regras. Quais fontes determinado agent pode consultar? Quanto token budget cada classe de informação recebe? Qual versão de uma policy está ativa? Qual freshness threshold é permitido? Dados de um tenant podem participar de uma consulta executada por outro? Essas decisões devem ser configuráveis e auditáveis, não espalhadas por prompts.
O Context Plane operacionaliza essas regras para cada inference step. Ele recebe task state, consulta o Control Plane, planeja retrieval, busca dados no Data Plane, aplica transformations e constrói o contexto materializado.
Essa divisão também melhora reliability. Uma falha no vector store pode ser tratada como degradação do Data Plane. Uma configuração incorreta de token budget pertence ao Control Plane. Uma estratégia ruim de reranking pertence ao Context Plane. Métricas e ownership tornam-se mais claros.
Para Staff AI Engineering, essa separação oferece ainda um benefício organizacional: diferentes equipes podem evoluir storage, governance e context optimization sem acoplamento excessivo. A arquitetura deixa de depender da implementação específica de um modelo e passa a tratar contexto como uma interface entre infraestrutura informacional e intelligence runtime.
2.2. Context Router e Context Planner: decidindo quais fontes consultar antes da inferência
Em sistemas com poucas fontes, recuperar tudo parece aceitável. À medida que a arquitetura cresce, essa estratégia produz fan-out excessivo, latência elevada e context pollution. Um Context Router resolve o primeiro problema: determinar quais fontes provavelmente contêm informação necessária para o estado atual da tarefa.
Routing pode combinar regras determinísticas e decisões model-based. Entidades explícitas podem direcionar consultas para sistemas específicos. Intent classification pode selecionar domínios. Metadata pode excluir stores incompatíveis com tenant, data sensitivity ou task type. Um lightweight model pode decidir se retrieval externo é necessário antes de acionar componentes mais caros.
O Context Planner atua um nível acima. Ele decide como construir evidência. Uma pergunta factual simples pode exigir apenas semantic search. Uma análise jurídica pode exigir hybrid retrieval, filtering temporal e reranking. Um coding agent talvez precise primeiro descobrir a estrutura do repositório e somente depois carregar arquivos específicos. Esse padrão de progressive disclosure reduz materialização prematura.
O planner também precisa administrar dependências. Certas queries só podem ser formuladas depois que uma tool retorna identificadores. Outras buscas podem ser executadas em paralelo. Portanto, Context Planning aproxima-se de query planning em distributed systems: existe um espaço de planos possíveis com diferentes custos, latências e probabilidades de recuperar evidência útil.
A decisão deve ser observável. Para cada fonte não consultada, deveria ser possível identificar a política ou score que levou à exclusão. Para cada chamada realizada, o sistema deveria registrar custo e contribuição posterior.
Esse nível de instrumentação permite transformar routing em um problema de optimization. Em vez de perguntar apenas se o sistema encontrou a resposta, passa-se a medir quais consultas foram realmente necessárias para encontrá-la.
2.3. Context Assembler: composição determinística de instructions, state, memory, retrieval e tool outputs
O Context Assembler é frequentemente subestimado porque sua saída final parece apenas uma sequência de mensagens. Entretanto, a ordem, a estrutura e a autoridade atribuídas às informações influenciam diretamente o comportamento do modelo. Em produção, assembler precisa ser muito mais próximo de um compiler do que de um string concatenator.
Cada fragmento deveria chegar acompanhado de metadata: source, timestamp, trust level, tenant, semantic type, token estimate, relevance score e retention policy. O assembler utiliza essas propriedades para resolver precedência, deduplicar material e aplicar budgets.
Uma composição típica pode separar invariants de task-local state. System policies e behavioral constraints devem ocupar uma região estável. O estado atual da tarefa precisa permanecer claramente distinguível de evidências externas. Retrieval deve preservar provenance. Tool outputs precisam ser identificados como observações, não como instruções. Dados potencialmente não confiáveis jamais deveriam compartilhar a mesma autoridade semântica de policies internas.
Determinismo também importa. Se o mesmo execution state e as mesmas fontes produzirem contextos materialmente diferentes sem explicação, debugging torna-se quase impossível. A seleção pode envolver componentes probabilísticos, mas o pipeline precisa registrar seus resultados e versões.
Outro requisito é graceful degradation. Quando o total excede o token budget, o assembler precisa aplicar uma política conhecida: remover redundância, compactar históricos, reduzir retrieval ou externalizar artifacts. Truncar arbitrariamente o final de uma sequência é uma política frágil.
A saída do assembler deveria ser tratada como artifact observável. Idealmente, cada inference span registra context manifest, não apenas o texto serializado. Isso permite reconstruir posteriormente quais informações foram disponibilizadas ao modelo quando uma decisão específica foi tomada.
2.4. Context Store, caching, lineage e versionamento: tornando contexto persistente e reproduzível
Context Runtime não deveria reconstruir toda informação desde zero em cada inference step. Parte do contexto é relativamente estável e pode ser armazenada ou reutilizada. Entretanto, caching em sistemas de AI exige cuidado porque igualdade textual não garante equivalência semântica, e reutilização incorreta pode introduzir stale state.
Um Context Store pode persistir diferentes artifacts: summaries, normalized retrieval results, entity profiles, execution checkpoints, intermediate analyses e snapshots de state. Cada item precisa carregar lineage. Quais dados originaram esse artifact? Qual modelo o produziu? Qual versão do prompt ou transformation foi utilizada? Quando foi criado? Qual policy define sua validade?
Caching pode atuar em vários níveis. Retrieval cache evita buscas repetidas. Embedding cache reduz recomputação. Prompt caching reaproveita prefixes estáveis. Semantic cache reutiliza outputs semelhantes, embora exija constraints rigorosos. Context fragment caching preserva blocos pré-processados que podem ser novamente materializados.
Versionamento é igualmente importante. Um answer produzido hoje pode ter utilizado policy version 17, schema version 5 e knowledge snapshot de ontem. Sem essas informações, incident analysis vira arqueologia.
Context lineage também permite avaliação causal. Se uma mudança no ranking melhora determinada métrica, é necessário saber quais fragments mudaram entre versões. Sem manifestos versionados, qualquer comparação fica contaminada por alterações invisíveis no estado informacional.
Para sistemas regulados, essa capacidade oferece auditabilidade. Em vez de registrar apenas prompt e response, pode-se reconstruir a cadeia de evidências e transformações que levou ao contexto final.
A propriedade desejada não é preservar todos os tokens para sempre. É conseguir reconstruir, com fidelidade suficiente, por que determinado conjunto de tokens chegou ao modelo em uma execução específica.
3. Context Supply Chain: retrieval, memory, tools e subagents sob um único modelo operacional
Retrieval, memory, tool calling e multi-agent orchestration costumam ser tratados como subsistemas independentes. Do ponto de vista do modelo, entretanto, todos resolvem a mesma necessidade fundamental: trazer informação relevante para o estado de decisão atual. Essa perspectiva permite tratá-los como uma Context Supply Chain.
Cada mecanismo possui características diferentes. Retrieval recupera informação externa a partir de uma necessidade corrente. Memory preserva informação produzida ou aprendida anteriormente. Tools observam ou modificam o ambiente e retornam novos dados. Subagents exploram espaços de problema em contextos isolados e devolvem resultados condensados.
O desafio arquitetural é coordenar essas fontes sem transformar a context window em um depósito de tudo que ocorreu. Um agente que executa cem ferramentas não precisa manter cem outputs integrais. Um workflow de pesquisa não precisa carregar todas as páginas visitadas. Um sistema conversacional não deveria preservar indefinidamente mensagens cujo conteúdo já foi consolidado em state estruturado.
O Context Runtime precisa definir regras de ingestão e retenção para cada tipo de informação. Dados facilmente recuperáveis podem ser externalizados. Decisões irreversíveis merecem persistência mais forte. Evidence usada para uma conclusão importante deve preservar provenance. Intermediate reasoning de baixo valor pode ser descartado.
Essa abordagem também simplifica arquitetura. Em vez de cada subsystem implementar seu próprio mecanismo de truncation, summarization e caching, a gestão pode ser unificada.
O resultado é uma visão operacional mais coerente: informação flui de diferentes produtores para um runtime que controla materialização. Context Engineering deixa de significar “como recuperar documentos” e passa a representar “como administrar toda a cadeia de suprimento informacional necessária à inteligência do sistema”.
3.1. Just-in-time retrieval versus preloading: quando materializar conhecimento no contexto
Preloading reduz latência de decisão porque informação já está disponível quando o modelo começa a raciocinar. O problema é que antecipar necessidade exige carregar dados antes de saber se serão úteis. Just-in-time retrieval inverte essa lógica: o agente mantém referências leves e materializa conteúdo apenas quando surge necessidade concreta.
Essa diferença tem implicações profundas em AI Engineering. Em tarefas previsíveis, como answering sobre um conjunto pequeno de políticas, retrieval antecipado pode produzir melhor latency profile. Em tarefas abertas, como investigação técnica ou análise de grandes codebases, preloading cria rapidamente context bloat. Abordagens recentes de agentes enfatizam progressive disclosure e retrieval em runtime justamente para preservar working context.
O trade-off principal envolve latency versus context efficiency. Just-in-time retrieval adiciona round trips, tool calls e possíveis falhas de infraestrutura. Entretanto, reduz tokens inúteis e permite que queries sejam formuladas com base em evidência descoberta anteriormente.
Uma estratégia madura tende a ser híbrida. High-priority invariants podem ser preloadados. Entity metadata pequena pode entrar imediatamente. Documentos extensos permanecem externalizados e são recuperados sob demanda. Informações caras de acessar podem ser speculative-prefetched quando a probabilidade de uso ultrapassa determinado threshold.
A decisão pode ser modelada economicamente. Para cada fragmento potencial, existem custo de retrieval, custo de tokens, probability of use e penalty caso não esteja disponível quando necessário.
O Context Planner pode usar esses sinais para escolher entre preload, prefetch ou lazy loading. Assim, retrieval deixa de ser um estágio fixo anterior ao LLM. Torna-se um mecanismo adaptativo de materialização semelhante a memória virtual, em que somente working sets relevantes ocupam recursos caros durante execução.
3.2. Memory hierarchy: working, episodic, semantic e procedural memory em workflows de longa duração
Um único memory store raramente atende às necessidades de agentes de longa duração. Diferentes classes de informação possuem frequência de acesso, validade e granularidade distintas. Uma arquitetura mais robusta organiza memória como hierarchy, aproximando-se de sistemas computacionais tradicionais.
Working memory representa informações necessárias ao raciocínio imediato. Ela vive próxima da context window e deve permanecer pequena. Episodic memory registra acontecimentos: decisões anteriores, interações, resultados de execuções e milestones. Semantic memory preserva conhecimento relativamente estável sobre entidades, conceitos ou preferências. Procedural memory armazena instruções sobre como executar tarefas, como policies, workflows ou reusable skills.
Essas camadas não precisam usar tecnologias diferentes, mas precisam de políticas diferentes. Working memory exige baixa latência. Episodic memory beneficia-se de temporal indexing. Semantic memory requer deduplication, consolidation e conflict resolution. Procedural memory exige versionamento e controle de autoridade.
O desafio mais complexo é promotion. Nem tudo que aparece na conversa merece tornar-se memória persistente. O runtime precisa decidir quais fatos sobrevivem após a sessão. Essa decisão pode considerar repetition, explicit importance, future utility e source reliability.
Também existe forgetting. Informações antigas podem ser substituídas, expirar ou se tornar contraditórias. Memory sem invalidation transforma-se em fonte de context poisoning interno.
Agentes long-running reforçam essa necessidade. Experimentos e sistemas recentes utilizam compaction, structured notes, external files e context resets para atravessar múltiplas janelas mantendo continuidade.
Em nível Staff, memory design não deveria começar pela escolha de vector database. Deve começar pela semântica de retenção: o que lembrar, por quanto tempo, com qual autoridade e sob quais condições esquecer.
3.3. Tool-result lifecycle: retenção, pruning, summarization, compaction e externalização de artifacts
Tool outputs são uma das maiores fontes de crescimento descontrolado de contexto em AI agents. APIs retornam JSON extensos, SQL produz milhares de linhas, browsers carregam documentos completos e code execution pode gerar logs enormes. Inserir cada resultado integralmente no message history transforma rapidamente a context window em armazenamento acidental.
A primeira regra é distinguir observation de artifact. Uma observation contém informação necessária para a próxima decisão. Um artifact é um resultado persistente que pode permanecer fora da janela e ser acessado por referência. Um CSV com cinquenta mil registros deve ser artifact; aggregates, anomalies e schema podem formar a observation.
Pruning precisa considerar dependências futuras. Outputs claramente superados podem desaparecer. Informações que sustentam uma decisão precisam preservar provenance mesmo quando compactadas. Summarization deve produzir representations estruturadas sempre que possível, porque textos livres dificultam atualização parcial.
Compaction também não deveria acontecer apenas quando a janela está quase cheia. Um runtime pode executar incremental compaction continuamente. Após uma sequência de tool calls relacionada ao mesmo objetivo, os resultados podem ser consolidados em um state object menor. Logs detalhados permanecem externalizados.
Outro ponto crítico é idempotency. Se um output for descartado, o sistema precisa saber se pode reproduzi-lo. Uma consulta read-only talvez seja repetível. Uma tool que realizou uma transação externa pode não ser. A retenção deveria refletir essa diferença.
Essa arquitetura reduz custo e melhora reasoning. O modelo recebe conclusões e referências, não ruído operacional.
Em produção, portanto, tool use precisa de lifecycle management equivalente ao de dados intermediários em um distributed dataflow. Produzir informação é apenas metade do problema; controlar quanto tempo ela permanece cognitivamente ativa é igualmente importante.
3.4. Subagents como mecanismo de context isolation, specialization e parallel context exploration
Multi-agent systems são frequentemente justificados por specialization ou parallelism, mas uma das vantagens mais importantes é context isolation. Um subagent pode explorar profundamente um subproblema sem poluir a working context do orchestrator principal com todos os detalhes encontrados durante investigação.
Imagine uma análise envolvendo segurança, performance e arquitetura de dados. Um único agente pode consultar dezenas de fontes de cada domínio e terminar com uma context window saturada. Com subagents especializados, cada worker recebe um scope menor, utiliza sua própria janela e retorna apenas evidence, conclusions, uncertainty e provenance necessários à síntese.
Esse padrão funciona como map-reduce cognitivo. Os workers expandem o espaço de busca; o orchestrator reduz resultados em uma representação manejável. Abordagens multi-agent modernas utilizam esse isolamento justamente para permitir exploração extensa sem transferir integralmente todos os tokens ao agente coordenador.
Entretanto, context isolation cria information loss. Um summary produzido por subagent pode remover um detalhe cuja importância só se torna evidente durante síntese. Por isso, handoffs precisam preservar pointers para artifacts e supporting evidence. O orchestrator deve poder solicitar drill-down quando necessário.
Outro trade-off é custo. Parallel subagents aumentam token consumption e tool fan-out. O ganho precisa compensar esse overhead. Problemas altamente decomponíveis tendem a beneficiar-se mais do padrão.
Subagents também podem criar trust boundaries. Um agente responsável por fontes externas pode operar em contexto separado, reduzindo exposição direta do orchestrator a prompt injection.
A decisão Staff-level não é “usar multi-agent ou não”. É determinar quando context isolation, parallel exploration e specialization justificam maior coordenação, custo e complexidade operacional.
4. Context Design System: contratos, políticas e budgets para controlar a composição do contexto
Design systems não precisam existir apenas para interfaces. Um sistema de AI em escala também se beneficia de um Context Design System: um conjunto explícito de primitives, contracts, policies e conventions que definem como informação pode entrar, circular e sair do contexto de modelos e agentes.
Sem esse design system, cada equipe inventa suas próprias regras. Um serviço serializa tool outputs como texto livre. Outro insere JSON bruto. Um terceiro trata retrieval como system message. Policies são copiadas entre prompts, token limits são hardcoded e provenance desaparece durante summarization. O resultado é uma plataforma impossível de governar de maneira consistente.
O Context Design System define tipos semânticos. Instruction não é evidence. Memory não é policy. Tool observation não é user input. External content não possui o mesmo trust level de dados internos. Essas distinções devem existir antes da serialização para qualquer provider.
Também são necessários contracts de tamanho, freshness, authority e retention. Um context fragment pode declarar que possui validade de quinze minutos, prioridade alta e limite de dois mil tokens. Outro pode exigir citação de sua source sempre que influenciar uma resposta.
Budgets fazem parte do mesmo sistema. Cada workload deveria possuir limites claros para retrieval, memory, history e tool results, preferencialmente ajustáveis por políticas.
Esse design reduz coupling com modelos específicos. O backend pode traduzir a representação canônica para diferentes message formats e context windows.
Para uma organização com múltiplos AI products, Context Design System torna-se plataforma. Ele permite compartilhar padrões de governance, evaluation e observability em vez de reproduzir Prompt Engineering artesanal em dezenas de aplicações independentes.
4.1. Typed Context e context contracts: schemas, ownership, trust levels e precedence rules
Texto puro destrói informação estrutural. Quando instructions, evidências, logs e resultados de tools são concatenados em uma única string, o sistema perde a capacidade de aplicar regras diferentes sobre cada classe de conteúdo. Typed Context resolve esse problema representando cada fragmento como um objeto semântico antes de convertê-lo em tokens.
Um context fragment poderia conter type, source, owner, timestamp, trust level, relevance, sensitivity, token budget e retention policy. Um fragmento do tipo policy pode ter precedence maior do que external evidence. Um tool result pode ser read-only observation. Conteúdo recuperado da Web pode receber trust level inferior e passar por sanitization.
Context contracts definem invariants. Por exemplo, todo fragmento sensível deve carregar tenant ID. Todo retrieval result precisa preservar document ID e version. Toda policy deve possuir owner e effective date. Todo summary derivado precisa apontar para suas source fragments.
Precedence rules são fundamentais quando informações entram em conflito. O modelo não deveria deduzir implicitamente qual fonte possui maior autoridade. O runtime precisa fornecer essa estrutura ou resolver a contradição antes da materialização.
Typed Context também facilita transformations. Compression pode ser aplicada a historical dialogue, mas não a uma cláusula regulatória que exige reprodução exata. Deduplication pode operar sobre evidence, mas nunca eliminar deliberadamente instruções obrigatórias.
Ownership melhora governança. Quando um fragmento causa incidente, deve ser possível identificar qual sistema ou equipe controla aquela fonte.
Essa arquitetura transforma contexto em dados tipados, não em texto acidental. A serialização para o LLM passa a ser a última etapa. Até esse momento, o runtime mantém informação rica o suficiente para executar validation, policy enforcement e observability com a mesma disciplina aplicada a APIs ou schemas distribuídos.
4.2. Token budgeting como resource allocation: quotas por fonte, reservas e adaptive allocation
Token budgeting deveria ser planejado antes que o sistema alcance o context limit. Quando truncation é acionada apenas como mecanismo emergencial, as informações removidas são determinadas pelo formato da conversa, não por importância. Um Context Runtime maduro aloca capacidade de forma explícita.
Imagine um modelo com budget operacional de cem mil tokens, mesmo que sua janela física seja maior. Uma parcela pode ser reservada para system instructions e policies. Outra para current task state. Retrieval pode receber um máximo variável. Tool outputs ocupam um pool temporário. Uma reserva permanece livre para resposta, reasoning adicional ou contingências.
Quotas rígidas são simples, mas frequentemente ineficientes. Tarefas de pesquisa precisam de retrieval maior; workflows transacionais podem exigir mais state e menos evidência textual. Adaptive allocation permite redistribuir espaço conforme task type, uncertainty e trajectory.
Uma abordagem interessante é tratar cada context source como consumidor com marginal utility estimada. Se os primeiros cinco chunks de retrieval agregam muita evidência e os seguintes quase nada, budget deveria migrar para outra fonte. Da mesma forma, histórico conversacional antigo pode ser compactado para liberar capacidade.
É importante manter headroom. Utilizar continuamente quase cem por cento da janela aumenta risco de overflow quando uma tool retorna mais dados que o esperado. Além disso, deixa pouco espaço para recuperação de erros.
Token budget também é cost budget. Em APIs cobradas por token, cada fragmento persistente pode ser reprocessado em dezenas de inference steps.
Portanto, resource allocation deve otimizar simultaneamente quality, latency e economics. O objetivo não é minimizar tokens indiscriminadamente. É garantir que cada token adicional continue produzindo benefício suficiente para justificar sua presença e seu custo ao longo da trajetória.
4.3. Provenance, freshness e temporal semantics: quando uma informação ainda pode ser considerada válida
Relevance sem provenance é perigosa. Um fragmento semanticamente perfeito pode ter origem desconhecida, baixa autoridade ou validade temporal expirada. Em sistemas de produção, Context Engineering precisa responder não apenas “isso parece relacionado?”, mas também “de onde veio, quando era verdadeiro e ainda é válido?”.
Cada fragmento recuperado deveria carregar source identity, retrieval timestamp, source version e, quando possível, effective time. Essa distinção é importante porque event time e retrieval time representam conceitos diferentes. Um contrato pode ter sido recuperado hoje, mas ter deixado de vigorar no mês passado.
Freshness policy precisa variar por domínio. Dados de mercado podem expirar em segundos. Informações sobre arquitetura interna talvez permaneçam válidas por semanas. Uma policy regulatória pode exigir controle de versão rigoroso, independentemente da idade.
Temporal retrieval é particularmente importante para RAG. Similarity search tradicional pode retornar documentos antigos porque continuam semanticamente próximos da query. Sem filtros ou reranking temporal, o modelo pode combinar versões incompatíveis.
Provenance também precisa sobreviver a summarization. Quando dez documentos são condensados em uma síntese, o novo artifact deveria preservar lineage suficiente para reconstruir as fontes utilizadas. Caso contrário, context compression destrói auditabilidade.
Outro problema é derived staleness. Mesmo que a source original seja atualizada, summaries, embeddings e caches derivados podem continuar representando a versão anterior. Invalidation precisa propagar-se pelo dependency graph.
Para AI Engineering em ambientes críticos, temporal semantics deve ser uma propriedade explícita do Context Runtime. Informação não é apenas conteúdo; é conteúdo associado a uma janela de validade.
A pergunta correta antes de materializar qualquer fragmento é: essa informação é relevante para a tarefa e verdadeira no tempo operacional que importa?
4.4. Context versioning e reproducibility: reconstruindo exatamente o estado informacional de uma execução
Reproduzir uma resposta de LLM exatamente pode ser difícil por causa de sampling, mudanças de provider e comportamento não determinístico. Entretanto, reproduzir o estado informacional que alimentou uma decisão é uma meta arquitetural realista e extremamente valiosa.
Cada inference step deveria possuir um Context Manifest. Esse manifesto registra fragments incluídos, versions, positions, scores, transformations, token counts e policies aplicadas. Também referencia model version, tool versions e runtime configuration.
Com esse artifact, incident analysis muda radicalmente. Em vez de perguntar “qual prompt usamos?”, a equipe pode reconstruir quais documentos foram recuperados, qual memory entry estava ativa, qual policy version possuía precedência e quais tool outputs foram removidos antes da chamada.
Versioning é especialmente importante em sistemas continuamente atualizados. Vector indexes são reprocessados, embeddings mudam, prompts evoluem e memory stores recebem novos fatos. Reexecutar uma query semanas depois pode produzir contexto diferente mesmo quando o código não mudou.
Reproducibility também melhora offline evaluation. Um dataset de eval pode armazenar manifests de contexto originais e comparar novas estratégias de retrieval ou compression sobre os mesmos inputs. Isso reduz confounding variables.
Para limitar storage, não é necessário persistir todo contexto bruto indefinidamente. Content-addressed storage, hashes e references podem preservar identidade sem duplicar grandes artifacts. Informações sensíveis podem seguir retention policies específicas.
O ponto Staff-level é reconhecer que model output é apenas o último estágio de uma cadeia versionada. Se essa cadeia não puder ser reconstruída, debugging, governance e experimentation tornam-se frágeis.
Em sistemas sérios de AI Engineering, Context Runtime deve produzir lineage tão naturalmente quanto observability distribuída produz traces.
5. Context Evaluation: como medir se o modelo recebeu o contexto certo, não apenas se respondeu certo
Avaliar apenas resposta final mistura múltiplos failure modes. Uma resposta incorreta pode resultar de retrieval ruim, contexto insuficiente, contexto contraditório, reasoning deficiente, tool failure ou incapacidade do modelo. Sem decomposição, equipes tentam corrigir prompts para problemas que pertencem à arquitetura de contexto.
Context Evaluation precisa, portanto, criar métricas intermediárias. Primeiro, o sistema recuperou as fontes relevantes? Depois, selecionou os fragments corretos? O contexto fornecido continha informação suficiente para resolver a tarefa? Havia ruído excessivo? O modelo utilizou efetivamente as evidências disponíveis? Por fim, a decisão final foi correta?
Essa decomposição permite diagnosticar bottlenecks. Recall alto com answer quality baixa pode indicar ranking ruim ou reasoning failure. Retrieval preciso com alta latência talvez exija caching. Uma melhoria de contexto pode elevar qualidade, mas aumentar custo acima do benefício econômico.
Evaluation também precisa atuar sobre trajectories, não apenas single-turn examples. Em agentes, uma decisão de contexto aparentemente pequena no passo cinco pode alterar tool selection e modificar todo o restante do workflow.
Para avaliar isso, traces precisam registrar Context Manifest, tool calls, state transitions e outcomes. A unidade de avaliação deixa de ser prompt-response e passa a ser execution trajectory.
Outra dimensão importante é causalidade. Se remover um fragmento não muda o resultado, talvez ele não esteja agregando valor. Se adicionar informação irrelevante degrada performance, o sistema é sensível a context pollution.
Context Evaluation madura conecta qualidade, custo e reliability. Ela responde não apenas se a saída está correta, mas quanto contexto foi necessário para produzi-la e quais decisões arquiteturais realmente contribuíram para o resultado.
5.1. Separando retrieval quality, context quality, reasoning quality e task outcome
Retrieval quality e context quality não são equivalentes. Um retriever pode obter todos os documentos relevantes e ainda produzir um contexto ruim se o assembler selecionar chunks redundantes, remover relações importantes ou ultrapassar o attention budget. Da mesma forma, contexto perfeito não garante resposta correta se o modelo falhar no reasoning.
Uma evaluation stack madura separa pelo menos quatro níveis. Retrieval quality mede candidate generation e ranking. Métricas como Recall@K, MRR e NDCG continuam úteis quando existe ground truth de documentos relevantes. Context quality avalia o conjunto efetivamente materializado depois de filtering, compression e budgeting.
Reasoning quality pergunta se o modelo utilizou adequadamente as informações recebidas. Uma estratégia útil é verificar groundedness e evidence attribution. Task outcome mede o resultado operacional: resposta correta, transação concluída, ticket resolvido, código aprovado ou investigação encerrada.
A separação evita falsas otimizações. Aumentar K pode melhorar Recall@K e simultaneamente piorar context quality devido ao ruído. Um reranker pode reduzir recall marginal, mas melhorar outcome ao aumentar concentração de evidência.
Essas métricas precisam ser segmentadas. Performance global pode esconder failure modes em consultas temporais, multi-hop, long-tail ou cross-domain.
Em agentes, também convém medir decision quality intermediária. Tool selection incorreta pode impedir que evidência essencial seja adquirida, mesmo que retrieval funcione perfeitamente quando chamado.
O pipeline ideal de evaluation permite localizar a etapa onde informação deixou de ser útil. Esse diagnóstico muda a prioridade de engenharia. Às vezes, trocar o embedding model é irrelevante; o gargalo está no assembler. Em outros casos, prompt tuning pouco ajuda porque a evidência necessária nunca chegou ao contexto.
5.2. Context precision, recall, coverage, utilization e marginal utility por token
Context precision mede quanto do material entregue ao modelo é realmente relevante. Context recall mede quanto da evidência necessária estava presente. Essas duas métricas reproduzem uma tensão clássica: contexto muito seletivo pode omitir fatos; contexto muito amplo aumenta ruído.
Coverage acrescenta outra dimensão. Uma tarefa pode exigir vários aspectos independentes, e recuperar muitos fragments sobre apenas um deles não resolve o problema. Coverage mede se o contexto cobre todos os subproblemas necessários.
Utilization tenta responder algo mais difícil: quais fragments disponíveis realmente influenciaram o resultado? Attribution perfeita em LLMs não é trivial, mas ablations, citations, attention proxies e perturbation tests podem oferecer sinais úteis.
Marginal utility per token é particularmente interessante para AI Engineering. O objetivo é estimar quanto ganho de outcome ocorre quando determinado bloco de informação é adicionado. Se os primeiros dois mil tokens de retrieval aumentam significativamente accuracy, mas os próximos dez mil geram ganho mínimo, existe um ponto de diminishing returns.
Essa análise pode produzir context efficiency curves. No eixo horizontal, tokens materializados; no vertical, qualidade. Diferentes estratégias de retrieval, compression e memory podem ser comparadas não apenas por score máximo, mas pela área eficiente da curva.
Também é possível incorporar custo monetário. Um fragmento que aumenta accuracy em 0,1% pode não justificar milhões de tokens adicionais por dia.
Para workloads em escala, essa visão é superior a otimizar apenas benchmark quality. O sistema precisa entregar qualidade suficiente dentro de SLOs econômicos.
Context Engineering torna-se, então, um problema multiobjetivo. Precision, recall e utilization descrevem qualidade informacional; latency e token cost descrevem custo operacional. O design correto está na fronteira de Pareto entre essas dimensões.
5.3. Ablation, perturbation e counterfactual evals: descobrindo quais partes do contexto realmente causam melhoria
Correlation entre presença de contexto e performance não demonstra contribuição causal. Um fragmento pode aparecer em todos os exemplos corretos simplesmente porque é comum, não porque o modelo depende dele. Ablation tests ajudam a descobrir quais componentes realmente sustentam o resultado.
A técnica mais simples remove uma categoria de contexto e mede a diferença. Executar sem episodic memory revela sua contribuição. Remover reranked retrieval mostra quanto o sistema depende dessa evidência. Substituir summaries por raw documents permite comparar compression strategies.
Perturbation tests vão além. É possível alterar datas, inverter valores, adicionar documentos semanticamente semelhantes porém irrelevantes ou inserir contradições controladas. O objetivo é observar se o modelo segue evidence authority ou apenas padrões superficiais.
Counterfactual evaluation cria contextos alternativos em que apenas uma variável muda. Se uma policy atualizada deveria alterar a decisão, o comportamento precisa acompanhar a nova versão. Caso contrário, alguma fonte antiga pode estar dominando o contexto.
Esses testes são especialmente importantes para segurança. Prompt injection resistance pode ser avaliada introduzindo instruções hostis dentro de external evidence e verificando se trust boundaries permanecem intactas.
Para resultados confiáveis, os experiments precisam controlar model version, decoding parameters e context manifest. Repetições podem ser necessárias para estimar variance.
A grande vantagem dessas técnicas é converter Context Engineering em ciência experimental. Em vez de decidir que um bloco “parece útil”, mede-se seu efeito marginal.
No nível Principal, esse tipo de evaluation permite simplificar arquiteturas. Componentes caros que não apresentam impacto causal consistente podem ser removidos. Outros, aparentemente pequenos, podem mostrar contribuição desproporcional e merecer budgets maiores ou proteção adicional.
5.4. Trace-based evaluation: avaliando decisões de contexto ao longo de trajectories multi-step
Single-turn evaluation é insuficiente para AI agents porque o resultado depende de uma cadeia de decisões. Uma escolha de retrieval no início pode determinar quais tools serão chamadas depois, que estado será construído e quais caminhos permanecerão possíveis. É necessário avaliar trajectories completas.
Trace-based evaluation registra cada inference span, tool call, state transition, context mutation e outcome. O Context Manifest de cada passo permite reconstruir exatamente quais informações estavam disponíveis antes de cada decisão.
A partir desses traces, é possível definir métricas temporais. Quantas vezes o agente recuperou a mesma informação? Quanto contexto foi carregado e descartado? Quantos tokens permaneceram ativos sem contribuição posterior? Quantas tool calls poderiam ter sido evitadas?
Também é possível identificar loops. Um agente pode alternar entre duas buscas porque o resultado anterior foi compactado cedo demais. Outro pode continuar consultando fontes porque seu state não registra explicitamente que determinada evidência já foi adquirida.
Trajectory evaluation ajuda a medir context debt. Decisões ruins acumulam-se ao longo do workflow. Um context fragment irrelevante pode levar a tool selection errada, que gera novos outputs inúteis e amplia ainda mais a poluição.
Para workloads long-running, checkpoints tornam-se unidades importantes. O sistema pode avaliar se o handoff entre janelas preservou objetivos, decisões, blockers e next actions. Experiências recentes com agentes persistentes mostram que context resets combinados com handoffs estruturados podem ser superiores a acumular indefinidamente histórico compactado.
Trace-based evaluation transforma observability em dataset. Cada execução real pode alimentar análise offline, regression testing e otimização do Context Runtime. É nesse ponto que evaluation deixa de ser etapa de validação e passa a funcionar como mecanismo contínuo de engenharia.
6. Reliability, observability e segurança do Context Runtime
Context Runtime faz parte do control path da aplicação. Se selecionar informação errada, todo reasoning posterior pode falhar mesmo quando modelo e tools funcionam corretamente. Portanto, reliability, observability e security precisam ser propriedades de primeira classe.
Reliability começa pela definição de failure semantics. O que acontece quando retrieval está indisponível? O sistema aborta, degrada para cache, consulta uma fonte alternativa ou responde com uncertainty explícita? O comportamento precisa depender da criticidade da informação, não de exceções genéricas.
Observability deve registrar mais que latência de inference. É necessário acompanhar token allocation, sources consulted, context size, pruning events, cache hits, freshness violations e contributions de cada etapa. Distributed tracing oferece uma boa abstração: cada decisão de contexto pode existir como span dentro da trajectory.
Segurança exige boundaries de confiança. Contexto externo pode conter instruções maliciosas. Memórias podem ter origem não confiável. Multi-tenant systems precisam garantir que retrieval nunca atravesse isolamento entre clientes. Authorization deve ocorrer antes da materialização, não depois que o dado já chegou ao LLM.
Além disso, contexto cria superfície de exfiltration. Um agent com acesso simultâneo a dados privados e tools externas pode transferir informação de forma não intencional. Policies de tool use precisam considerar o conteúdo já presente no contexto.
Essas preocupações convergem. Provenance necessária para debugging também auxilia segurança. Typed Context usado para budgeting pode carregar sensitivity labels. Versioning utilizado em evaluation também melhora auditoria.
Uma arquitetura Staff-level evita implementar reliability, observability e security como camadas posteriores. Elas precisam existir dentro do modelo de dados do Context Runtime desde sua primeira versão.
6.1. Context observability: tracing de provenance, token allocation, retrieval decisions e compaction events
Logs de prompts e responses são insuficientes para entender sistemas agentic. Eles mostram o estado final serializado, mas escondem o processo que decidiu quais informações entraram ou saíram. Context observability precisa instrumentar esse processo.
Cada inference span deveria registrar um context summary operacional. Quantos tokens foram dedicados a policies? Quantos vieram de retrieval? Quanto histórico foi compactado? Quais fragments foram excluídos por budget? Quais sources foram consultadas e quais foram ignoradas?
Retrieval tracing deveria armazenar query, filters, candidate scores, reranker outputs e final selection. Assim, quando uma resposta falha, é possível distinguir ausência de candidate de erro de ranking.
Compaction events também merecem spans próprios. O runtime deveria registrar input size, output size, compression ratio e fragments preservados. Se um fato crítico desaparecer depois de uma compactação, a causa torna-se observável.
Provenance pode ser representada como links entre spans e artifacts. Um summary aponta para documentos; uma decisão aponta para summary; um tool call aponta para a decisão que o iniciou. O trace forma um grafo de causalidade operacional.
Métricas agregadas complementam tracing. Token cost per successful task, retrieval calls per trajectory, context reuse rate, stale-fragment rate e average effective context size ajudam a identificar regressões.
É importante evitar registrar dados sensíveis indiscriminadamente. Observability deve permitir redaction, hashing ou referências para content stores protegidos.
Com essa infraestrutura, context debugging deixa de depender de inspeção manual de prompts gigantes. Engineers podem localizar o instante em que a qualidade informacional degradou.
Context observability deveria ocupar, para AI systems, papel semelhante ao distributed tracing em microservices: tornar visível a execução de um pipeline que, sem instrumentação, parece uma caixa-preta.
6.2 Staleness, invalidation e consistency: tratando contexto como estado distribuído
Contexto frequentemente é uma visão derivada de múltiplos sistemas que evoluem independentemente. Uma memory entry pode refletir estado antigo; um vector index pode estar minutos atrás do database; um cached summary pode derivar de documento já atualizado. Esse problema é fundamentalmente de distributed state.
Strong consistency raramente é necessária para toda informação. Porém, o runtime precisa conhecer as guarantees de cada source. Uma consulta a saldo financeiro pode exigir leitura atual. Uma descrição institucional tolera eventual consistency.
Freshness budgets tornam essa escolha explícita. Um fragmento pode declarar idade máxima aceitável. Caso ultrapasse o threshold, o Context Planner precisa refazer retrieval ou marcar uncertainty.
Invalidation é mais difícil quando artifacts são derivados. Se um documento muda, embeddings precisam ser atualizados. Summaries construídos a partir dele talvez precisem expirar. Semantic caches baseados na versão anterior também podem se tornar inválidos. Essa dependência forma um DAG de lineage.
Event-driven invalidation pode reduzir staleness. Mudanças em sources publicam eventos que invalidam caches e derived artifacts. Para outros domínios, TTL pode ser suficiente.
Consistency também importa dentro de uma única context assembly. Recuperar diferentes entidades em instantes distintos pode criar snapshot inconsistente. Workloads críticos podem exigir transaction IDs ou versioned snapshots para garantir coerência temporal.
Outro failure mode aparece em long-running agents. O ambiente pode mudar enquanto o agente mantém estado antigo. Antes de executar ações irreversíveis, o runtime deveria revalidar assumptions importantes.
Essas decisões pertencem ao Context Runtime porque ele materializa informação para reasoning. Tratar staleness apenas no storage layer é insuficiente.
No nível Principal, a pergunta não é se todo contexto está atualizado. É qual consistency model cada decisão exige e quanto custa oferecer essa garantia em escala.
6.3. Prompt injection, context poisoning e trust boundaries entre fontes internas e externas
Prompt injection é frequentemente descrita como problema de prompting, mas sua origem arquitetural está na ausência de trust boundaries. Quando instruções de autoridade alta e conteúdo externo não confiável são materializados sem distinção, espera-se que o modelo resolva sozinho um problema de segurança que deveria ser tratado pelo sistema.
Typed Context permite marcar external content como data, não instruction. Isso não elimina injection, mas cria condições para políticas adicionais. Conteúdo recuperado pode passar por sanitization, classifiers ou structural extraction antes de chegar ao modelo.
Context poisoning é mais persistente. Uma informação maliciosa pode entrar em memory ou knowledge base e continuar influenciando execuções futuras. Por isso, promotion para memória precisa considerar source trust, authorization e validation.
Tool use amplia o risco. Um documento pode tentar induzir o agente a enviar dados para uma API externa. O policy engine precisa avaliar action intent independentemente do texto que originou a solicitação. Sensitive operations devem exigir explicit authorization ou approval gates.
Trust boundaries também existem entre subagents. Um worker que pesquisa conteúdo público pode retornar findings para um orchestrator com acesso privilegiado. Handoffs deveriam preservar provenance e trust classification, evitando que resultados externos sejam promovidos automaticamente à mesma autoridade de policies internas.
Outro mecanismo importante é least privilege. O Context Runtime deve filtrar dados de acordo com capacidades reais do agente e da task. Informação desnecessária não deve entrar no contexto simplesmente porque poderia ser útil.
Segurança melhora quando contexto é tratado como supply chain. Cada fragmento possui origem, transformação e destino.
A arquitetura segura não pergunta apenas “o modelo seguirá a instrução maliciosa?”. Ela reduz sistematicamente a probabilidade de conteúdo não confiável adquirir autoridade suficiente para influenciar decisões privilegiadas.
6.4. Multi-tenant isolation, PII, authorization e policy enforcement antes da materialização do contexto
Em plataformas multi-tenant, context leakage é um failure mode crítico porque modelos podem revelar informação recebida mesmo quando essa informação não deveria ter sido carregada. A defesa correta acontece antes da inference boundary.
Authorization precisa ser aplicada na retrieval query e novamente na materialização. Filters baseados em tenant, user, role e purpose of use devem limitar candidates antes do ranking. Post-filtering é insuficiente quando sistemas intermediários já processaram dados não autorizados.
PII requer tratamento semelhante. Algumas aplicações precisam do dado original; outras podem trabalhar com masked representation. O Context Runtime pode executar tokenization, redaction ou pseudonymization de acordo com task policy.
A distinção entre authorization e relevance é importante. Um documento altamente relevante pode continuar proibido. Scores de retrieval jamais deveriam sobrepor access control.
Policies também precisam considerar tool execution. Um agente autorizado a ler determinada informação pode não estar autorizado a transmiti-la para serviços externos. Isso exige data-flow awareness: o runtime deve saber quais sensitivity labels estão presentes no contexto quando uma ação é proposta.
Multi-tenant caching merece cuidado especial. Cache keys precisam incorporar security scope. Semantic cache compartilhado pode gerar cross-tenant leakage mesmo quando os prompts parecem equivalentes.
Auditability fecha o ciclo. Cada contexto materializado deveria registrar quais policy decisions permitiram inclusão de dados sensíveis.
Para workloads regulados, purpose limitation pode ser tão importante quanto identity. A mesma pessoa pode acessar um dado em um processo e não em outro.
Essa arquitetura reforça um princípio simples: uma vez que informação sensível foi materializada no contexto do modelo, sua contenção torna-se muito mais difícil. Portanto, policy enforcement deve ocorrer na fronteira de aquisição, antes que relevância semântica transforme um dado proibido em token disponível ao reasoning.
7. Economics e trade-offs: projetando contexto para qualidade, latência e custo em escala
Context Engineering possui uma economia própria. Cada token carregado pode ser processado repetidamente durante uma trajectory; cada retrieval adiciona latência e infraestrutura; cada subagent aumenta fan-out; cada cache consome storage e cria risco de staleness. A arquitetura correta precisa otimizar custo por tarefa concluída, não custo isolado por chamada ao modelo.
Long context reduz complexidade de retrieval em alguns cenários, mas transfere custo para inference. RAG reduz tokens processados, porém introduz indexes, ranking, atualização e failure modes adicionais. Memory aumenta continuidade, mas exige retention e invalidation. Compression reduz tamanho, mas pode eliminar informação crítica.
A escolha deve partir de workload characteristics. Quantos passos existem? Qual parcela da informação muda? Quanto conteúdo pode ser recuperado novamente? Qual latência é tolerada? Qual custo de uma resposta errada?
O conceito central é marginal economics. Se duplicar retrieval tokens melhora pouco a qualidade, essa expansão provavelmente não justifica custo. Se um reranker adiciona vinte milissegundos e reduz pela metade o contexto downstream, pode gerar economia líquida. Se prompt caching reaproveita um prefixo enorme entre execuções, uma arquitetura aparentemente verbosa pode ser economicamente eficiente.
Em escala, pequenas diferenças tornam-se relevantes. Cem tokens adicionais em um único request são irrelevantes; multiplicados por milhões de inference steps, tornam-se infraestrutura.
Staff AI Engineering exige, portanto, conectar evaluation técnica a unit economics. Cada decisão sobre context window, retrieval, memory, compression e routing precisa ser observada em qualidade, latency e cost.
A melhor arquitetura não é a que utiliza menos contexto. É a que maximiza valor produzido por unidade de recurso consumido.
7.1. Long context versus retrieval versus memory versus compression: onde cada estratégia realmente vence
Long context, retrieval, memory e compression não são estratégias mutuamente exclusivas. Cada uma resolve um tipo diferente de problema de disponibilidade informacional, e arquiteturas maduras normalmente combinam as quatro.
Long context funciona bem quando o dataset relevante é relativamente pequeno, coeso e necessário em grande parte da tarefa. Ele reduz complexidade de orchestration, mas pode aumentar custo e attention dilution.
Retrieval é superior quando existe um corpus grande e apenas uma fração é necessária por decisão. Seu custo está em candidate generation, ranking, indexing e possibilidade de missing evidence.
Memory resolve continuidade temporal. Ela preserva fatos, decisões ou estado entre sessões sem carregar toda a história. Entretanto, exige promotion, consolidation, forgetting e access control.
Compression reduz informação já adquirida para liberar working capacity. Sua principal desvantagem é lossy transformation. Um summary pode preservar a conclusão e eliminar detalhe necessário mais tarde.
A estratégia correta depende de recoverability. Informação facilmente recuperável pode permanecer fora da janela. Estado difícil de reconstruir merece persistência. Conteúdo que precisa de fidelidade textual não deve sofrer aggressive compression.
Também importa access frequency. Dados consultados constantemente podem beneficiar-se de preloading ou caching. Dados raros devem ser lazy-loaded.
Uma arquitetura híbrida pode manter policies e compact state sempre presentes, recuperar documentos sob demanda, persistir memories importantes e compactar trajectories periodicamente.
O erro está em transformar uma técnica em dogma. “Context window grande elimina RAG” ignora economics e relevance. “Tudo deve virar retrieval” ignora latency. “Memory resolve long-running agents” ignora consistency.
O papel do Context Runtime é escolher dinamicamente qual mecanismo oferece a melhor relação entre fidelity, availability, cost e cognitive load para cada classe de informação.
7.2. Cost-per-task e quality-per-token: modelando o custo econômico do contexto, não apenas o custo do LLM
Custo por token é uma métrica de billing. Cost-per-task é uma métrica de negócio. A diferença é fundamental porque reduzir tokens por chamada pode aumentar número de chamadas, retries ou failures, elevando o custo total.
Um modelo econômico de Context Runtime precisa incorporar input tokens, output tokens, retrieval infrastructure, reranking, embedding, tool execution, storage, cache e subagent fan-out. Também deveria considerar custo esperado de erro quando outcomes possuem impacto financeiro.
Quality-per-token mede eficiência informacional. Entretanto, essa métrica deve ser observada dentro da trajectory completa. Um bloco de contexto adicional pode parecer caro em uma chamada, mas evitar três tool calls posteriores e reduzir custo total.
Expected cost pode ser condicionado por task class. Perguntas simples merecem context plans baratos. Casos complexos podem justificar models maiores, retrieval profundo e múltiplos agentes.
Esse princípio permite construir adaptive compute. O runtime começa com uma estratégia econômica e escala recursos quando uncertainty, task complexity ou risk justificam.
Outra métrica relevante é cost per successful task. Ela penaliza arquiteturas aparentemente baratas que falham frequentemente. Se um workflow de dez centavos resolve apenas metade dos casos, pode ser menos eficiente do que um workflow de quinze centavos com alta conclusão.
Unit economics também influencia caching. Um cache caro de manter pode ser excelente quando reuse rate é alto e péssimo em long-tail workloads.
Para Principal AI Engineers, economics precisa entrar no design review desde o início. Não basta apresentar benchmark improvements. Cada melhoria deve ser relacionada a volume esperado, latency impact e infrastructure cost.
Context Engineering em escala é um exercício de alocação econômica: gastar tokens, retrieval e compute exatamente onde aumentam a probabilidade de sucesso em magnitude suficiente para pagar por eles.
7.3 Latency budgets, caching e model routing: como contexto altera o critical path da aplicação
Context construction frequentemente domina uma parcela relevante do critical path antes mesmo que o primeiro token seja gerado. Retrieval, reranking, permission checks, memory lookup, tool calls e serialization acumulam latência. Por isso, Context Engineering também é performance engineering.
Latency budget deveria ser distribuído explicitamente. Se um endpoint possui SLO de dois segundos, não faz sentido permitir que retrieval consuma um segundo e meio sem avaliar impacto no restante do pipeline.
Parallelism pode reduzir critical path. Fontes independentes podem ser consultadas simultaneamente. Entretanto, fan-out excessivo aumenta tail latency porque a resposta passa a depender do componente mais lento.
Caching reduz esse custo quando existe reuse. Prefixes estáveis podem aproveitar prompt caching. Retrieval results podem ser reutilizados dentro de freshness bounds. Entity profiles e policies podem permanecer materializados em caches próximos ao runtime.
Model routing também se conecta a contexto. Um lightweight model pode executar classification, routing ou compression. Um modelo mais forte entra apenas quando a tarefa exige reasoning profundo. Essa decomposição evita usar frontier models para operações contextuais simples.
Speculative retrieval é outra opção. Se o sistema prevê quais fontes provavelmente serão necessárias, pode iniciar buscas enquanto outras etapas executam. O risco é desperdiçar recursos.
Streaming também precisa ser considerado. Algumas respostas podem começar antes que todos os context sources estejam disponíveis; outras exigem snapshot completo para preservar correctness.
A arquitetura deve observar p50, p95 e p99, não apenas average latency. Um reranker rápido na média pode introduzir long tails perigosos.
Context Runtime, portanto, participa diretamente do latency SLO. Otimizar apenas model inference ignora uma parte crescente do trabalho. Em sistemas agentic, intelligence começa muito antes da chamada ao LLM, e cada decisão sobre contexto pode prolongar ou encurtar o critical path.
7.4. Do Context Window ao Context Runtime: princípios arquiteturais para sistemas Staff-level em produção
A evolução de Context Engineering pode ser resumida como uma mudança de unidade de pensamento. No início, a unidade era o prompt. Depois passou a ser a context window. Em sistemas de produção, a unidade correta é o runtime que governa informação ao longo de toda a trajetória.
O primeiro princípio é materializar apenas o working set necessário. Disponibilidade de dados não implica necessidade de tokens. O segundo é preservar structure. Instructions, evidence, state, memory e tool outputs possuem semânticas diferentes e devem permanecer tipados até a serialização.
O terceiro princípio é tornar contexto observável. Toda inclusão, exclusão, compression e retrieval decision precisa deixar evidência suficiente para debugging e evaluation.
O quarto é tratar provenance, freshness e trust como parte da informação, não metadata opcional. Um fato sem origem ou validade conhecida não deveria possuir a mesma autoridade de uma evidência controlada.
O quinto é externalizar estado. Context window deve funcionar como working memory, não como database. Artifacts, long-term memory e logs pertencem a stores apropriados.
O sexto é avaliar causalmente. Mais contexto não é automaticamente melhor. Ablations e trajectory evals devem demonstrar quais informações realmente melhoram outcomes.
Por fim, economics precisa fechar o design. Contexto custa tokens, latency, storage, retrieval e complexidade operacional.
À medida que agent harnesses evoluem, a indústria já trata context management, tools, subagents e persistent execution como componentes explícitos da infraestrutura de agentes, reforçando essa direção arquitetural.
O salto Staff/Principal acontece quando Context Engineering deixa de significar “como caber na janela” e passa a significar “como controlar o estado informacional de um sistema inteligente”. Esse é o papel do Context Runtime.