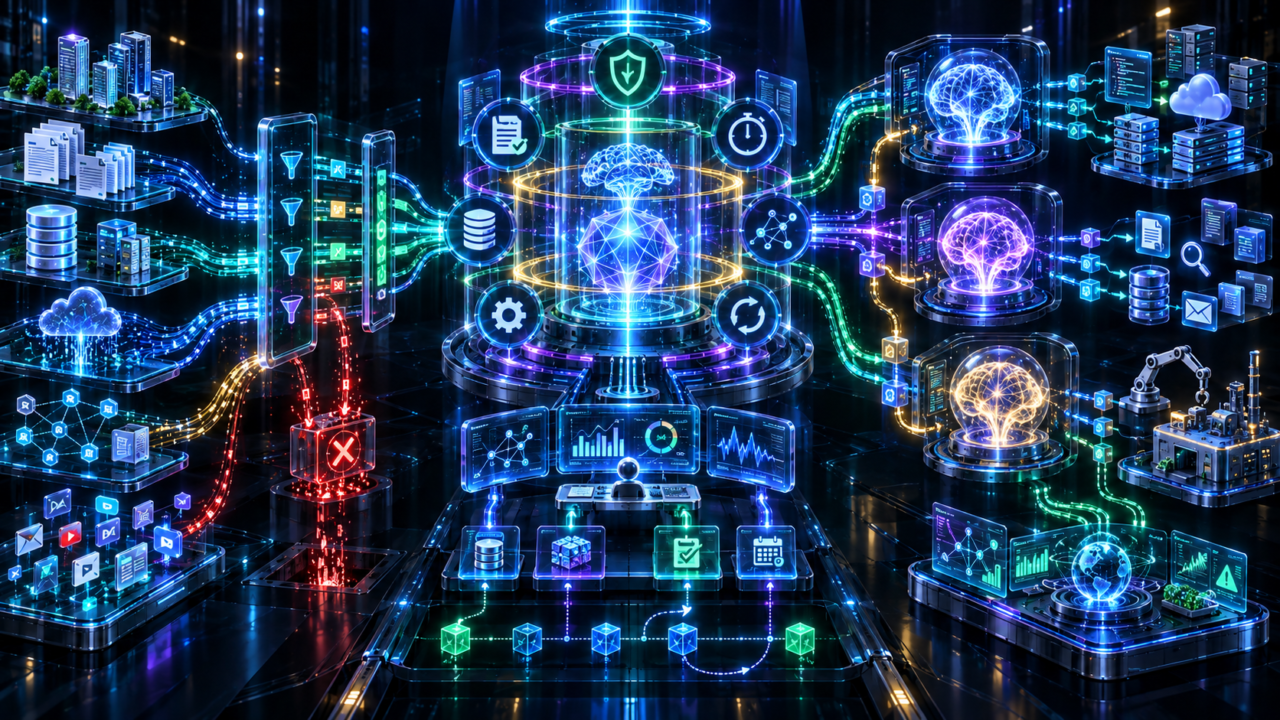
Um AI Agent em produção deve ser compreendido como um sistema distribuído stateful cuja lógica de decisão contém componentes probabilísticos. O modelo decide, planeja, seleciona ferramentas e reformula estratégias, mas essas decisões atravessam filas, bancos, APIs, sandboxes, mecanismos de memória e serviços externos que possuem suas próprias failure semantics. A confiabilidade end-to-end não depende apenas da qualidade do LLM, mas da forma como o runtime converte decisões probabilísticas em state transitions controladas.
Essa perspectiva desloca o centro arquitetural do agent loop para o Agent Runtime. O runtime precisa controlar durable state, task ownership, retries, cancellation, concurrency, budgets, tool execution, policy enforcement, checkpoints, context construction e observability. O modelo continua sendo responsável pelo reasoning, mas deixa de possuir autoridade implícita sobre execução. Autonomia passa a existir dentro de um envelope operacional definido por invariants verificáveis.
Em sistemas de AI Engineering, a diferença entre uma demonstração convincente e um sistema autônomo confiável aparece justamente nessas fronteiras. Um agente pode produzir excelentes decisões locais e ainda falhar globalmente por duplicar efeitos, recuperar estado incorretamente, perder ownership de subtarefas ou extrapolar custos. Projetar AI Agents de longa duração exige, portanto, tratar autonomia como uma propriedade do sistema inteiro, e não como uma capacidade isolada do modelo.
Fale comigo no LinkedIn: https://www.linkedin.com/in/celso-sousa/
1. Do Agent Loop ao Agent Runtime: o problema arquitetural real
O agent loop clássico comprime em poucas linhas uma quantidade perigosa de responsabilidades: construir contexto, consultar o modelo, interpretar tool calls, executar ferramentas, atualizar estado e decidir se a tarefa terminou. Essa simplicidade é útil durante prototipação porque reduz friction, mas também esconde decisões de correctness que inevitavelmente aparecem quando a execução atravessa processos, serviços ou períodos longos de tempo.
Em produção, cada iteração do loop produz efeitos que precisam ser identificáveis, persistíveis e reconciliáveis. Uma resposta do modelo pode iniciar múltiplas subtarefas, uma tool call pode continuar executando depois de um timeout, e um worker pode desaparecer antes de registrar que determinado efeito foi concluído. O problema deixa de ser iterar mensagens e passa a ser preservar causalidade entre decisões, transições de estado e efeitos observáveis.
Por isso, um Agent Runtime deve ser projetado como infraestrutura de execução. Ele estabelece ownership, controla lifecycle, materializa checkpoints e define quais operações podem ser repetidas. O LLM fornece inteligência adaptativa, mas o runtime fornece as propriedades sistêmicas que tornam essa inteligência operacionalmente utilizável.
1.1. Por que agentes de longa duração devem ser tratados como sistemas distribuídos stateful
Um long-running agent mantém estado lógico enquanto executa trabalho sobre componentes fisicamente distribuídos. Parte desse estado pode residir em um workflow store, parte em object storage, parte em memória semântica e parte dentro de serviços externos alterados pelo próprio agente. Como resultado, o sistema passa a conviver com os mesmos problemas de distributed systems: partial failure, delayed delivery, duplicate execution, stale reads, inconsistent replicas e ambiguous outcomes.
A diferença crítica é que o grafo de execução não precisa ser totalmente conhecido antecipadamente. O modelo pode decidir em runtime que novas ferramentas devem ser chamadas ou que uma tarefa precisa ser subdividida. Isso cria uma topologia dinâmica na qual o número de operações, dependências e side effects emerge durante a própria execução.
Consequentemente, cada ação relevante precisa possuir identidade, estado e ownership explícitos. O runtime deve conseguir determinar se uma operação foi apenas planejada, iniciada, confirmada ou ficou em estado ambíguo. Sem essa distinção, retries transformam-se em fonte de inconsistência. Long-running agents precisam, portanto, ser modelados como stateful distributed computations nas quais o raciocínio probabilístico altera dinamicamente o execution graph.
1.2. Separação entre control plane, execution plane e intelligence plane
Uma arquitetura madura evita que planejamento, governança e execução compartilhem o mesmo boundary operacional. O intelligence plane concentra funções probabilísticas como planning, decomposition, model routing, reasoning e verification. Ele produz propostas de ação, mas não deve controlar diretamente credenciais, quotas ou recursos críticos.
O execution plane transforma essas propostas em operações concretas. É nele que vivem tool workers, sandboxes, connectors e adapters para sistemas externos. Sua responsabilidade é aplicar uma ação dentro de parâmetros claramente definidos, registrar seu resultado e retornar evidência suficiente para que o runtime determine o próximo estado.
O control plane coordena ambos. Ele gerencia workflow state, scheduling, admission control, policies, approvals, retries, cancellation e budgets. Essa separação cria uma boundary de confiança: o modelo pode decidir que uma operação é útil, mas somente o control plane determina se ela é permitida, financeiramente admissível e semanticamente válida naquele estado. Além de melhorar segurança, a separação permite escalabilidade independente. Model inference, orchestration e tool execution possuem perfis de recursos diferentes e não deveriam competir pela mesma capacidade operacional.
1.3. Agent Runtime como máquina de estados: transitions, invariants, ownership e durable execution
Representar a execução como uma máquina de estados explícita muda a forma como correctness é raciocinada. Em vez de assumir que a sequência de chamadas ocorreu corretamente, o runtime registra transitions entre estados como planning, executing, waiting_external, waiting_approval, retrying, suspended, completed ou failed. Cada transição possui preconditions e invariants que podem ser verificados independentemente do conteúdo gerado pelo modelo.
Esse modelo é particularmente importante porque long-running agents atravessam falhas de processo. Se um worker desaparecer, o workflow não pode depender de variáveis locais para saber o que fazer a seguir. O estado durável precisa conter informação suficiente para que outro executor reassuma ownership e continue a partir de uma boundary consistente.
Ownership também precisa ser temporariamente exclusivo. Leases, fencing tokens ou mecanismos equivalentes podem impedir que dois workers executem simultaneamente a mesma transição depois de uma falha de coordination. A combinação de durable state, explicit transitions e ownership transforma falhas de infraestrutura em eventos recuperáveis. O runtime deixa de depender da continuidade física do processo e passa a preservar a continuidade lógica do workflow.
1.4. Determinismo, autonomia e controle: onde o runtime deve restringir o modelo
O comportamento do modelo pode permanecer probabilístico sem que a execução inteira seja operacionalmente imprevisível. A arquitetura precisa separar liberdade de decisão de autoridade de execução. O LLM pode escolher entre estratégias alternativas, mas invariants críticos devem permanecer fora de sua esfera de controle.
Retries, authorization, secret access, resource allocation, idempotency e commit de operações destrutivas não deveriam depender de uma instrução textual ao modelo. Essas propriedades precisam ser enforced pelo runtime por meio de regras determinísticas, schemas, policies e state guards.
Esse desenho cria um envelope de autonomia. Dentro dele, o agente pode explorar caminhos e adaptar o plano; fora dele, decisões são bloqueadas ou escaladas. O tamanho desse envelope deve depender de reversibilidade, impacto financeiro, sensibilidade dos dados e possibilidade de verificação automática. Quanto maior o blast radius de uma ação, menor deveria ser a quantidade de autoridade transferida diretamente ao model loop. Em arquiteturas Staff-level, o objetivo não é maximizar autonomia indiscriminadamente, mas definir precisamente quais decisões podem permanecer probabilísticas sem comprometer os invariants do sistema.
2. Durable Execution: estado, checkpoints e recuperação após falhas
Durable execution significa preservar o progresso semântico do agente independentemente da vida útil de processos, containers ou workers. Em execuções curtas, uma falha pode ser resolvida reiniciando a requisição. Em workflows que duram horas ou dias, reiniciar do início pode repetir trabalho caro, invalidar decisões intermediárias ou duplicar efeitos externos.
O desafio não está apenas em persistir dados, mas em escolher quais fatos constituem o estado autoritativo da execução. O runtime precisa distinguir informação reconstruível de informação cuja repetição alteraria a trajetória. Outputs de modelos, approvals, external commits, tool responses e policy decisions podem precisar ser persistidos porque reexecutá-los produziria um estado diferente.
Durability também altera a semântica de recuperação. Depois de uma falha, o runtime precisa identificar o último ponto consistente, reconstruir ownership e determinar quais efeitos já ocorreram. Essa propriedade aproxima Agent Runtimes de workflow engines, transaction coordinators e event-driven systems. A persistência não serve apenas para retomar trabalho; ela preserva causalidade suficiente para garantir que a retomada continue semanticamente compatível com a execução original.
2.1. Estado efêmero versus estado durável: projetando a fronteira de persistência
A durability boundary define quais dados precisam sobreviver a falhas e quais podem ser recomputados. Essa decisão deve considerar não apenas custo de recomputação, mas também não determinismo, external effects e importância para auditabilidade. Um embedding intermediário pode ser reconstruído; uma decisão de autorização provavelmente não deveria depender de uma nova avaliação posterior.
Estado durável deve representar fatos semanticamente relevantes: transições concluídas, outputs que influenciaram decisões, versões de policies, resultados de ferramentas, checkpoints e side-effect confirmations. Estado efêmero pode incluir caches, buffers temporários e estruturas auxiliares cuja perda não modifica a semântica do workflow.
O principal risco é usar conversation history como source of truth. Histórico de mensagens é uma representação orientada ao modelo, não necessariamente uma representação correta do estado operacional. Sistemas maduros mantêm structured state separado do conversational context. O contexto é reconstruído a partir de fontes duráveis, enquanto o workflow store registra fatos de execução. Essa separação reduz acoplamento entre prompt format e correctness, permitindo evoluir modelos e estratégias de context engineering sem alterar a semântica transacional do runtime.
2.2. Checkpointing, event sourcing e replay: reconstruindo execuções sem repetir efeitos externos
Checkpointing e event sourcing resolvem problemas diferentes. Checkpoints materializam uma visão consistente do estado em pontos específicos, reduzindo recovery time. Event sourcing registra a sequência de eventos que levou até aquele estado, preservando causalidade, provenance e auditabilidade. Quando combinados, permitem reconstrução eficiente sem abrir mão do histórico de decisões.
Para Agent Runtimes, entretanto, replay não pode significar simplesmente executar novamente todas as etapas. Model calls são probabilísticas e ferramentas podem produzir side effects irreversíveis. O sistema precisa diferenciar replay lógico de reexecução física. Logical replay reconstrói estado a partir de eventos gravados; physical replay dispara novamente computação ou ferramentas somente quando isso é explicitamente seguro.
Essa distinção também habilita offline evaluation. Um trace real pode ser reproduzido usando tool outputs registrados enquanto diferentes modelos ou policies são avaliados sobre o mesmo estado. Dessa forma, é possível realizar análise contrafactual sem reenviar e-mails, alterar bancos ou executar pagamentos. Event history passa então a servir simultaneamente a recovery, debugging, auditoria e experimentation.
2.3. Idempotency, deduplication e effect isolation: aproximando exactly-once semantics no mundo real
Exactly-once delivery end-to-end é difícil de obter porque não existe uma transação única envolvendo runtime, filas, modelos e serviços externos. A estratégia prática é construir exactly-once effects sobre mecanismos que podem operar com at-least-once execution.
Cada side effect precisa possuir uma operation identity estável. Retries devem reutilizar essa identidade, permitindo que o destino detecte duplicações. Quando o sistema externo não oferece suporte nativo a idempotency keys, o runtime pode introduzir effect ledgers, deduplication stores ou wrappers transacionais que mantenham o mapping entre intenção e resultado.
Effect isolation fortalece essa arquitetura. A decisão do modelo não deve executar imediatamente a ação. O runtime primeiro persiste a intenção, depois autoriza o executor, registra o resultado e finalmente materializa a transição correspondente. Essa separação evita o clássico failure window no qual um side effect foi aplicado, mas a confirmação se perdeu antes de ser persistida. O princípio central é que retry safety precisa ser definida por operação. Repetir compute costuma ser aceitável; repetir external effects exige uma semântica explícita.
2.4. Recovery semantics para workflows que executam durante horas, dias ou centenas de passos
Recovery semantics precisam distinguir tipos de falha porque retry não é uma resposta universal. Uma falha de rede antes do envio de uma requisição é diferente de um timeout após o serviço remoto possivelmente ter concluído a operação. O primeiro caso permite retry direto; o segundo pode exigir reconciliation antes de qualquer nova tentativa.
Long-running workflows também enfrentam version drift. Enquanto uma execução está suspensa, modelos, prompts, tool schemas ou policies podem mudar. Retomar automaticamente com as versões mais recentes pode alterar invariants originalmente válidos. Por isso, execution metadata deve incluir versões de workflow, policy, tool contract e model configuration.
O runtime também precisa definir quando uma execução é migrável. Alguns estados podem ser convertidos para uma nova versão; outros precisam continuar no runtime antigo ou ser encerrados. Essa decisão é semelhante a schema migration em sistemas stateful. Recovery, portanto, não é apenas tolerância a infraestrutura instável. É preservação de semântica diante de mudanças temporais. Em sistemas autônomos de longa duração, resumir recovery a “reexecutar o último passo” ignora justamente os casos em que o mundo externo já evoluiu desde o momento da falha.
3. Orquestração sob falhas: scheduling, concorrência e lifecycle de tarefas
Agentic workflows frequentemente produzem grafos de execução dinâmicos. Um planner pode decompor uma tarefa, criar child agents, disparar chamadas independentes e agregar os resultados posteriormente. Essa dinâmica transforma orchestration em um problema de scheduling distribuído, não apenas em lógica de aplicação.
Cada novo branch consome capacidade e amplia o failure surface. Se cada subtarefa criar outras subtarefas, o número de operações pode crescer exponencialmente. O scheduler precisa controlar breadth, depth, concurrency e resource consumption antes que a estratégia escolhida pelo modelo se transforme em load amplification.
Além disso, o runtime precisa definir como falhas se propagam pelo grafo. Um branch crítico pode invalidar toda a execução; um branch opcional pode falhar sem interromper o resultado. A semântica precisa ser explícita porque o modelo não deveria improvisar regras de lifecycle em cada execução. Scheduling, concurrency e cancellation formam uma camada de correctness: elas determinam quais trabalhos podem existir, por quanto tempo, sob qual ownership e com quais condições de término.
3.1. Structured concurrency para agents: parent-child ownership, fan-out, fan-in e propagação de falhas
Structured concurrency fornece uma disciplina para impedir que tarefas escapem do lifecycle de seus parents. Cada child task pertence a um escopo, e o parent não pode simplesmente desaparecer enquanto filhos continuam consumindo recursos sem supervisão. Para Agent Runtimes, esse modelo ajuda a transformar delegation em uma relação de ownership verificável.
Fan-out precisa declarar limites e semantics. O runtime pode restringir número de children, profundidade de delegação e quantidade de execuções simultâneas. Fan-in, por sua vez, precisa definir se o parent exige all-success, quorum, first-success ou best-effort aggregation.
Essas escolhas influenciam reliability e latency. Esperar todos os branches maximiza completude, mas aumenta tail latency. First-success reduz tempo, mas pode ignorar resultados de maior qualidade. O runtime deve tornar essa política observável e configurável. Em multi-agent architectures, structured concurrency também previne orphan agents: uma subtarefa que perdeu seu parent precisa ser cancelada, reparented ou explicitamente promovida a uma execução independente. Delegation deixa assim de ser apenas uma decisão semântica e passa a possuir lifecycle semantics formais.
3.2. Timeouts, retries e retry budgets: evitando retry storms e cascatas de falha
Timeouts precisam ser derivados do deadline global da execução. Se cada dependência recebe um timeout independente e generoso, o agente pode ultrapassar seu latency SLO mesmo que nenhuma operação individual viole configuração local. O runtime deve propagar deadline e calcular quanto tempo cada nova ação ainda pode consumir.
Retries também precisam respeitar budgets globais. Um serviço degradado pode provocar milhares de agentes a repetir chamadas simultaneamente, produzindo retry amplification e pressionando ainda mais a dependência. Backoff com jitter reduz sincronização, mas não limita consumo agregado. Retry budgets por service, tenant ou workflow são necessários para impedir tempestades.
Outro ponto é a classificação do erro. Connection reset, validation failure e ambiguous timeout não deveriam compartilhar a mesma retry policy. O runtime precisa distinguir erros transitórios, permanentes e semanticamente ambíguos. Circuit breakers podem bloquear novas chamadas durante degradação conhecida, enquanto fallback paths redirecionam a execução. Em sistemas agentic, retry engineering precisa ser orientada a custo e correctness. A pergunta relevante não é “quantas vezes tentar?”, mas “quanto valor adicional uma nova tentativa pode gerar antes de comprometer latency, cost ou consistency?”.
3.3. Agent cancellation semantics: cancelamento distribuído, compensação e side effects parcialmente concluídos
Cancellation deve ser modelado como protocolo, não como interrupção local. Quando uma execução é cancelada, o runtime precisa impedir novos trabalhos, propagar sinais aos children, reconciliar operações em andamento e decidir o que fazer com efeitos já aplicados.
Isso exige estados intermediários. Uma task pode estar cancellation_requested enquanto espera uma ferramenta terminar. Outra pode estar compensating porque já produziu um side effect. Tratar todas como simplesmente cancelled apaga informação necessária para correctness.
Também existem races inevitáveis. Uma operação pode concluir no mesmo momento em que o cancelamento é persistido. O runtime precisa definir qual transição é legal e como evitar que completion e cancellation sejam processados por workers diferentes em ordens inconsistentes. Fencing tokens ou compare-and-swap sobre workflow state podem ajudar a serializar essas transições. Para side effects reversíveis, sagas podem executar compensation; para efeitos irreversíveis, o runtime precisa apenas registrar que o cancelamento ocorreu após o commit. Cancellation semantics são, portanto, parte do modelo transacional do Agent Runtime.
3.4. Backpressure, admission control e resource quotas: protegendo o runtime contra autonomia descontrolada
Requests per second na borda não representam corretamente a carga gerada por agentes. Uma única requisição pode produzir dezenas de model calls, centenas de tool invocations e grandes volumes de estado. O admission control precisa estimar workload amplification antes de aceitar a execução.
Essa estimativa pode usar task class, historical cost, model choice, expected depth e tenant limits. O objetivo não é prever exatamente o custo, mas evitar iniciar trabalhos cuja execução não cabe no resource envelope disponível.
Backpressure também precisa ser transitiva. Se uma tool queue está saturada, o planner não deveria continuar produzindo child tasks dependentes daquele recurso. Sinais de saturação precisam retroalimentar scheduling e até model strategy. Quotas podem ser aplicadas por tokens, concurrent runs, tool calls, sandbox time, storage ou execution duration. O desafio principal é coordenar esses limites entre workers distribuídos sem transformar o control plane em bottleneck. Em plataformas maduras, autonomia é condicionada à capacidade disponível. O agente pode escolher como resolver a tarefa, mas o runtime controla quantos recursos sistêmicos essa estratégia está autorizada a mobilizar.
4. Tool Runtime e Safety Boundaries: executando ações sem transformar o agente em uma superfície de risco
Tools mudam radicalmente o threat model de um AI Agent. Enquanto um modelo isolado produz informação, um agente com ferramentas pode alterar sistemas, enviar dados, executar código e desencadear transações. A segurança precisa, portanto, ser aplicada na boundary entre decisão e efeito.
Essa boundary deve ser tratada como um Tool Runtime. Ele valida inputs, resolve identities, injeta credentials, verifica policies, impõe rate limits e registra intents. A tool call gerada pelo modelo funciona apenas como proposta estruturada de ação; a autorização final pertence à infraestrutura.
Essa separação também reduz o impacto de prompt injection. Conteúdo não confiável pode induzir o modelo a solicitar uma ação, mas não deveria ser suficiente para atravessar policy checks ou obter credenciais além do escopo autorizado. O design correto assume que o reasoning layer pode ser manipulado e constrói enforcement fora dele. Em AI Engineering, safety eficaz não depende de instruções comportamentais no system prompt. Depende de capabilities limitadas, trust boundaries claras e controles verificáveis no execution path.
4.1. Tool registry, capability model e contratos tipados para execução confiável
Um Tool Registry precisa representar mais do que metadata para function calling. Ele deve funcionar como catálogo de capabilities operacionalmente governadas. Cada capability pode declarar schema, version, permission scope, owner, expected latency, idempotency characteristics, reversibility e risk class.
Contratos tipados reduzem ambiguidade entre o modelo e o executor, mas type safety não equivale a semantic safety. Um valor pode ser válido no schema e ainda violar regras de negócio. Por isso, validation precisa ocorrer em múltiplas camadas: estrutura, domínio e policy.
Versioning também é essencial. Se uma tool muda seu contrato durante um workflow de longa duração, replay e recovery podem se tornar inconsistentes. Execuções precisam referenciar uma versão estável ou passar por adapters compatíveis. Capability-oriented design também reduz privilégios. Em vez de expor um client genérico para um sistema, o runtime disponibiliza operações estreitas e semanticamente claras. Isso melhora segurança e tool selection, porque o modelo trabalha sobre um espaço de ações com menor ambiguidade. O registry torna-se, assim, parte da control surface da plataforma agentic.
4.2. Sandboxing, least privilege e isolamento por tenant, tarefa e ferramenta
Agentes capazes de executar código precisam operar sob um zero-trust assumption. Inputs do usuário, documentos recuperados e outputs de ferramentas podem conter instruções maliciosas ou simplesmente comportamentos inesperados. O sandbox deve assumir que o código gerado é não confiável.
Isolamento precisa abranger filesystem, network, process tree, CPU, memory, execution time e access to secrets. Para workloads de maior risco, containers compartilhando kernel podem não fornecer isolamento suficiente; microVMs ou sandboxes especializados podem oferecer boundaries mais fortes.
Least privilege deve ser contextual. Uma task de leitura não deveria receber credenciais capazes de escrita. Secrets podem ser short-lived e emitidos apenas para a capability necessária, reduzindo blast radius. Tenant isolation também precisa alcançar caches, memory stores, logs e artifacts. Um vazamento cross-tenant causado por retrieval incorreto é uma falha arquitetural, não apenas um erro do modelo. Sandboxing e privilege separation precisam ser projetados como propriedades end-to-end do execution plane, porque qualquer breach nessa camada transforma uma decisão probabilística em acesso operacional excessivo.
4.3. Policy engines, approval gates e risk-based authorization para ações de alto impacto
Policies deveriam ser avaliadas sobre a ação concreta, e não apenas sobre a identidade do usuário. Uma mesma capability pode ser de baixo risco para determinado recurso e crítica para outro. O policy engine precisa receber contexto suficiente para calcular essa diferença.
Atributos como tenant, user role, tool, target resource, data sensitivity, estimated financial impact e reversibility podem compor a decisão. O resultado pode ser allow, deny ou require_approval. Dessa forma, human-in-the-loop é aplicado seletivamente onde o risco excede a capacidade de verificação automática.
Approval gates também precisam ser duráveis. Um approval deve estar associado a uma versão específica da ação; se argumentos mudarem posteriormente, a autorização antiga não deveria continuar válida. Isso evita time-of-check versus time-of-use inconsistencies. Policies precisam igualmente ser versionadas para auditoria e replay. A questão central não é somente impedir ações perigosas, mas conseguir provar por que uma ação foi permitida naquele momento. Em ambientes regulados, essa explainability operacional é tão importante quanto a qualidade do output do modelo.
4.4. Transações, compensating actions e sagas para ferramentas com efeitos irreversíveis
Agentes frequentemente coordenam operações sobre sistemas que não compartilham uma transação global. Isso impede atomicidade clássica e exige mecanismos de consistência distribuída. Saga orchestration é um modelo natural para representar sequências de ações e compensações.
Cada step precisa declarar não apenas como executar, mas também se existe uma compensating action e qual semântica ela possui. Compensação raramente restaura perfeitamente o estado anterior. Cancelar uma reserva pode gerar taxa; excluir um registro não desfaz uma comunicação já recebida.
O runtime precisa, portanto, modelar business semantics. Quando uma etapa falha, a decisão pode ser retry, compensate, pause for manual intervention ou continue with degraded semantics. Para ações irreversíveis, o sistema deve deslocar validação e approval para antes do commit. O modelo pode sugerir a sequência, mas não deveria inventar em tempo de execução as garantias transacionais. Essas propriedades pertencem ao Tool Runtime e precisam ser testadas independentemente do LLM. Quanto mais agentes operam processos empresariais reais, mais transaction design se torna parte central de AI Engineering.
5. Context Runtime: memória, conhecimento e coerência ao longo de centenas de passos
Context management em long-running agents é um problema de state representation. A cada passo, o runtime precisa decidir quais informações continuam relevantes, quais foram invalidadas e quais evidências devem ser apresentadas novamente ao modelo. Enviar todo o histórico não resolve esse problema; apenas transfere a seleção para mecanismos internos de atenção do LLM.
Um Context Runtime maduro funciona como camada de mediação entre estado autoritativo e contexto de inferência. Ele consulta memória, workflow state, knowledge stores e outputs anteriores, aplica políticas de freshness e monta uma view específica para a decisão atual.
Essa separação é importante porque o contexto do modelo é transitório, enquanto o estado do sistema precisa permanecer consistente. Resumos podem mudar, prompts podem evoluir e modelos podem ser substituídos sem alterar os fatos duráveis da execução. Context Engineering torna-se, portanto, uma forma de query planning sobre informação operacional. O objetivo não é fornecer ao modelo tudo o que o sistema sabe, mas construir a menor representação que preserve informação suficiente para a próxima decisão.
5.1. Context Engineering como subsistema: seleção, compressão, priorização e provenance
Context construction pode ser modelada como pipeline de evidence selection. Primeiro, fontes candidatas são identificadas; depois, evidências são filtradas, ordenadas, comprimidas e organizadas em uma representação adequada ao modelo.
Cada uma dessas etapas possui trade-offs. Retrieval agressivo aumenta recall, mas também noise. Compression reduz tokens, mas pode remover qualifiers importantes. Priorization melhora signal density, mas pode amplificar vieses do ranking. Por isso, context engineering precisa ser observável e avaliável como subsistema independente.
Provenance é especialmente importante. O modelo deveria receber informação sobre origem, recency e authority das evidências quando isso influencia a decisão. Dados fornecidos diretamente pelo usuário possuem semântica diferente de uma inferência gerada em passos anteriores. Essa distinção ajuda a impedir que conjecturas internas sejam recicladas como fatos. Context views também podem ser especializadas por função. Planners, verifiers e tool executors não precisam observar exatamente o mesmo conjunto de informações. Essa abordagem reduz context pollution e melhora separation of concerns dentro do Agent Runtime.
5.2. Working memory, episodic memory e semantic memory: diferentes consistências para diferentes estados
Memória agentic precisa ser decomposta por função. Working memory contém o estado necessário para continuar a execução atual. Ela deve refletir task goals, constraints, active plans e recent observations com baixa ambiguidade.
Episodic memory registra experiências anteriores e pode auxiliar strategy reuse. Entretanto, episódios são exemplos históricos, não regras universais. Eles precisam ser contextualizados por outcome, environment e recency para evitar transferência inadequada de comportamento.
Semantic memory representa conhecimento relativamente estável sobre entidades, relações ou domínio. Ela pode exigir mecanismos de truth maintenance, temporal validity e conflict resolution que vector similarity sozinha não oferece. Por isso, arquiteturas maduras combinam vector indexes com relational stores, graphs ou canonical data sources. A escolha do storage deve seguir a semântica da memória, não uma preferência tecnológica. Diferentes memórias também requerem diferentes consistency models. Working state pode precisar de strong consistency, enquanto episodic retrieval pode tolerar eventual consistency. “Memória do agente” deixa assim de ser um componente único e passa a ser uma arquitetura de dados heterogênea.
5.3. Context drift, stale state e conflicting evidence: impedindo degradação silenciosa em execuções longas
Long-running agents operam em ambientes mutáveis. Uma informação correta no início da execução pode estar obsoleta dezenas de passos depois. Sem freshness semantics, o runtime pode continuar tomando decisões sobre uma versão antiga do mundo.
Cada evidência relevante pode carregar timestamp, version ou validity interval. Quando o agente precisa reutilizá-la, o runtime decide se o dado ainda pode ser considerado válido ou se deve ser reconsultado. Essa política depende do domínio: uma configuração de infraestrutura pode mudar a qualquer momento, enquanto determinado documento normativo pode permanecer estável por meses.
Conflicting evidence também precisa ser tratada explicitamente. Se duas fontes divergem, o Context Runtime deve aplicar authority rules, temporal ordering ou reconciliation logic, em vez de simplesmente concatenar ambas. Outro risco é summary drift. Resumos recursivos podem progressivamente alterar nuances até que a representação compacta deixe de corresponder à fonte original. Para fatos críticos, summaries devem apontar para evidence anchors persistentes. Coerência de longo prazo exige uma arquitetura em que informação possua lifecycle, não apenas relevância semântica.
5.4. Context budgets e memory economics: quando recuperar, resumir, persistir ou descartar informação
Context é um recurso computacional acumulativo. Em agent loops extensos, cada token mantido pode ser retransmitido dezenas de vezes, transformando pequenas decisões de retenção em grande amplificação de custo.
Por isso, memory policy deve considerar expected future utility. Informações críticas e difíceis de reconstruir justificam persistência. Dados facilmente reconsultáveis podem ser mantidos fora do prompt e recuperados sob demanda. Structured state é preferível para fatos operacionais porque possui maior densidade informacional e menor ambiguidade do que narrativa textual.
Summarization também deve ser aplicada economicamente. Resumir cada etapa adiciona inference cost e pode introduzir information loss. Uma arquitetura melhor seleciona pontos em que compression efetivamente reduz custo futuro. Adaptive retrieval pode utilizar task complexity ou uncertainty para determinar quanto contexto recuperar. Essa estratégia conecta context engineering a runtime economics. O objetivo é minimizar cost per correct decision, não simplesmente tokens por chamada. Em sistemas de grande escala, políticas de contexto podem ter impacto financeiro comparável à escolha do próprio modelo.
6. Evaluation e Observability: como provar que um agente continua correto depois do primeiro passo
Agent evaluation precisa considerar que erros podem surgir em qualquer ponto da trajetória. Um resultado final aparentemente correto não demonstra que o processo foi seguro, eficiente ou reproduzível. O agente pode ter utilizado ferramentas incorretas, ignorado constraints ou produzido side effects desnecessários antes de chegar à resposta.
Observability fornece a evidência operacional necessária para analisar essas trajetórias. O runtime precisa capturar causalidade entre model decisions, context state, tool execution, policy checks e workflow transitions. Sem essa ligação, traces tradicionais mostram latência e erros técnicos, mas não explicam por que o agente tomou determinada decisão.
Evaluation e observability deveriam compartilhar uma representação comum de run. Production traces podem alimentar datasets de avaliação; incidentes podem ser transformados em regressions; e novas versões de modelos podem ser testadas sobre estados reais previamente observados. Esse loop conecta comportamento em produção à evolução da plataforma. A maturidade não vem apenas de possuir dashboards ou benchmarks, mas de transformar cada failure mode relevante em uma propriedade continuamente verificável do sistema.
6.1. Avaliação de trajetórias: por que task success e final-answer accuracy são insuficientes
Task success mede apenas um ponto do sistema: o outcome. Para agentes, isso é insuficiente porque múltiplas trajetórias podem produzir o mesmo resultado com perfis de risco e custo radicalmente diferentes.
Uma execução pode chegar à resposta correta depois de loops redundantes, ferramentas desnecessárias e chamadas caras. Outra pode concluir a tarefa eficientemente. Se ambas recebem o mesmo score, a avaliação ignora eficiência operacional.
Trajectory evaluation adiciona dimensões como step count, tool appropriateness, policy adherence, recovery behavior, unnecessary side effects e resource consumption. Entretanto, a trajetória não deveria ser comparada rigidamente a um gold path quando existem múltiplas soluções válidas. É mais robusto definir invariants obrigatórios e propriedades desejáveis. O agente pode variar sua estratégia desde que preserve constraints essenciais. Essa distinção permite inovação de comportamento sem perder controle. Em sistemas agentic, a unidade correta de avaliação não é apenas “resposta”, mas a relação entre outcome, processo e recursos utilizados para alcançá-lo.
6.2. Step-level, trajectory-level e outcome-level evaluation para sistemas agentic
Evaluation precisa operar em camadas porque diferentes falhas aparecem em granularidades diferentes. Step-level metrics detectam argumentos inválidos, tool selection incorreta, hallucinated references ou violation de policies locais.
Trajectory-level analysis observa padrões temporais: looping, unnecessary delegation, premature commitment, context drift ou falhas de recuperação. Outcome-level evaluation mede o estado final do mundo e verifica se a tarefa realmente foi concluída.
Esses níveis não deveriam ser condensados em um score único sem preservar informação de diagnóstico. Uma melhoria pequena em average outcome pode esconder aumento significativo de policy violations. Por isso, avaliações devem ser segmentadas por task class, model version, tool set, risk category e complexity bucket. Distribution tails também importam. Um agente com excelente média, mas casos raros de comportamento catastrófico, pode ser inadequado para tarefas críticas. O sistema de evaluation precisa apoiar decisões de arquitetura, não apenas leaderboard comparison. Ele deve responder onde autonomia é segura, quando utilizar modelos mais fortes e quais failures permanecem inaceitáveis independentemente da média global.
6.3. Tracing causal: decisões do modelo, tool calls, state transitions, custos e side effects
Tracing de Agent Runtimes precisa representar causalidade semântica. Um model call deve apontar para o state version e para a context view utilizados. A decisão resultante deve estar conectada à tool invocation correspondente e à state transition produzida depois da execução.
Esse grafo causal permite explicar não apenas onde houve latência, mas por que determinada ação existiu. Cost attribution pode seguir a mesma estrutura: tokens, model inference, tool charges e sandbox usage são associados à etapa que os consumiu.
Essa visibilidade é fundamental para optimization. Se uma versão de planner aumenta custos, o trace pode revelar se o problema veio de reasoning mais longo, maior branching factor ou recuperação excessiva de contexto. Telemetry, entretanto, precisa respeitar data governance. Prompts completos podem conter dados sensíveis e não deveriam ser armazenados indiscriminadamente. Hashes, structured metadata, redaction e selective sampling podem preservar debuggability sem transformar observability em novo vetor de exposição. O objetivo é manter informação causal suficiente para reproduzir decisões relevantes.
6.4. Failure taxonomy, counterfactual evaluation e replay para debugging de comportamentos emergentes
Uma failure taxonomy consistente transforma incidentes isolados em dados analisáveis. Classificações como planning failure, retrieval failure, stale context, tool misuse, timeout ambiguity, policy rejection ou execution inconsistency permitem identificar padrões que seriam invisíveis em métricas agregadas.
Depois de classificado, o caso pode ser convertido em replay scenario. Tool outputs e state snapshots registrados permitem executar novamente decisões sem repetir efeitos externos. Diferentes modelos, prompts ou policies podem então ser comparados sobre o mesmo estado.
Counterfactual evaluation ajuda a identificar causalidade. Se um novo modelo resolve o caso mantendo todos os demais componentes fixos, existe evidência de model limitation. Se ambos falham, o problema pode estar no contexto, no tool contract ou na orchestration logic. Essa metodologia reduz a tendência de atribuir todo comportamento ruim ao LLM. Em sistemas complexos, a maior parte da melhoria vem de localizar corretamente a camada responsável pelo erro. Replay transforma produção em laboratório controlado e cria uma ponte direta entre incident response e regression testing.
7. Production Economics e System Design: projetando autonomia dentro de SLOs e budgets
Agentic systems possuem uma característica econômica importante: o custo é determinado pela trajetória, não apenas pela entrada. Um único request pode gerar dezenas de inferências, múltiplas ferramentas e grande volume de estado. Consequentemente, cost per request é menos informativo do que cost per successful task.
Essa dinâmica exige que SLOs e budgets façam parte da lógica do runtime. O agente precisa saber, direta ou indiretamente, quanto tempo e compute ainda pode consumir. Decisões de model routing, parallelism e retrieval podem então ser adaptadas ao budget restante.
Economics também influencia arquitetura. Um sistema pode melhorar quality ao adicionar verificadores, reranking, speculative paths e modelos maiores, mas cada camada aumenta custo e latência. A decisão Staff-level é identificar onde compute adicional produz ganho marginal suficiente para justificar sua introdução. Autonomia, nesse sentido, é um recurso econômico. Quanto maior a liberdade de exploração permitida ao agente, maior a necessidade de mecanismos capazes de limitar search depth, branching e expensive reasoning.
7.1. Latency, reliability e cost budgets: autonomia como recurso finito do sistema
Budgets transformam objetivos abstratos em constraints operacionais. Um execution budget pode limitar wall-clock time, tokens, model calls, tool invocations ou custo monetário. Esses limites devem ser consumidos ao longo da trajetória e influenciar decisões posteriores.
Latency budgets precisam considerar tail behavior. Em workflows sequenciais, a latência total resulta da composição de múltiplas distribuições, fazendo com que p95 e p99 cresçam rapidamente. Parallelism pode reduzir critical-path latency, mas aumenta custo e contention.
Reliability também pode ser pensada como budget. Cada dependência adicional introduz probability of failure. Um plano com dez serviços externos pode ser semanticamente superior, mas operacionalmente inferior a outro com três. O planner não precisa calcular formalmente essa probabilidade, mas o runtime pode incorporar reliability metadata na seleção de estratégias. Quando budgets se aproximam do limite, o sistema pode degradar qualidade de forma controlada, reduzir exploration ou retornar partial results. Essa abordagem torna autonomia consciente de constraints e evita que o agente trate recursos como infinitos.
7.2. Model routing, speculative execution e adaptive reasoning: onde gastar inteligência
Model routing deve otimizar o workflow, e não cada chamada isoladamente. Um modelo menor pode ser mais barato por token, mas exigir mais passos ou gerar erros que provocam retries. O critério relevante é expected cost per successful outcome.
Adaptive reasoning permite alocar compute de acordo com task complexity e uncertainty. Tarefas simples seguem rotas curtas; situações ambíguas podem escalar para modelos mais capazes ou verificadores adicionais. Essa política pode usar sinais como disagreement, low confidence, tool errors ou task risk.
Speculative execution reduz latency ao explorar caminhos em paralelo, mas precisa ser restrita a etapas cujo custo adicional seja justificável e cujos side effects possam ser adiados. Um padrão seguro é especular sobre planning e read-only retrieval, escolher o melhor branch e somente então permitir commits externos. Model routing, speculative execution e verification formam, assim, uma política de compute allocation. O Agent Runtime decide onde inteligência adicional possui valor marginal suficiente, evitando que todos os passos utilizem o modelo mais caro ou o reasoning mais profundo indiscriminadamente.
7.3. Capacity planning para agentes: duração, concorrência, tokens, tool calls e state amplification
Capacity planning tradicional baseado em request rate não captura a dinâmica agentic. É necessário modelar internal workload amplification. Uma entrada pode gerar várias inferências, branches e artifacts, criando uma relação não linear entre tráfego externo e consumo interno.
Métricas como active workflows, average task depth, branching factor, model calls per run, tool calls per run e state bytes per run são mais úteis para estimar capacidade. O sistema também precisa diferenciar waiting concurrency de active concurrency. Mil workflows aguardando aprovação humana consomem persistent state, mas pouco compute; cem sandboxes executando código podem saturar rapidamente recursos.
State amplification afeta storage e observability. Long-running agents produzem traces, checkpoints, embeddings, artifacts e logs que podem crescer mais rápido do que a carga de inferência. Capacity planning precisa incluir retention e compaction policies. Além disso, bottlenecks podem migrar ao longo do tempo. Após otimizar model serving, tool executors ou workflow storage podem se tornar o novo limite. A plataforma precisa ser tratada como uma queueing network, não como um único serviço de inference.
7.4. Build versus platform: decisões arquiteturais para evoluir um Agent Runtime sem criar uma distributed monolith
À medida que múltiplos produtos passam a utilizar agentes, surge pressão para centralizar capabilities comuns. Durable execution, identity, policy enforcement, tracing, tool registry e quotas possuem características horizontais e podem ser oferecidos como platform primitives.
Entretanto, abstração prematura cria um risco diferente: uma plataforma tão genérica que força todos os agentes a adotar o mesmo lifecycle, mesmo quando domínios possuem requirements distintos. A arquitetura precisa separar invariants estáveis de domain-specific orchestration.
Interfaces devem ser orientadas a contracts e versionadas. Um runtime compartilhado não deveria conhecer detalhes de negócio, enquanto aplicações não deveriam reimplementar cancellation, retries ou observability. Essa separação reduz duplication sem criar coupling excessivo. Outro princípio importante é não amarrar a plataforma a um único model provider ou agent framework. Esses componentes mudam rapidamente; execution semantics, state management e policy tendem a permanecer mais estáveis. O investimento arquitetural de longo prazo deve, portanto, concentrar-se nas propriedades duráveis que permitem substituir modelos, ferramentas e frameworks sem reescrever a infraestrutura responsável por confiabilidade.