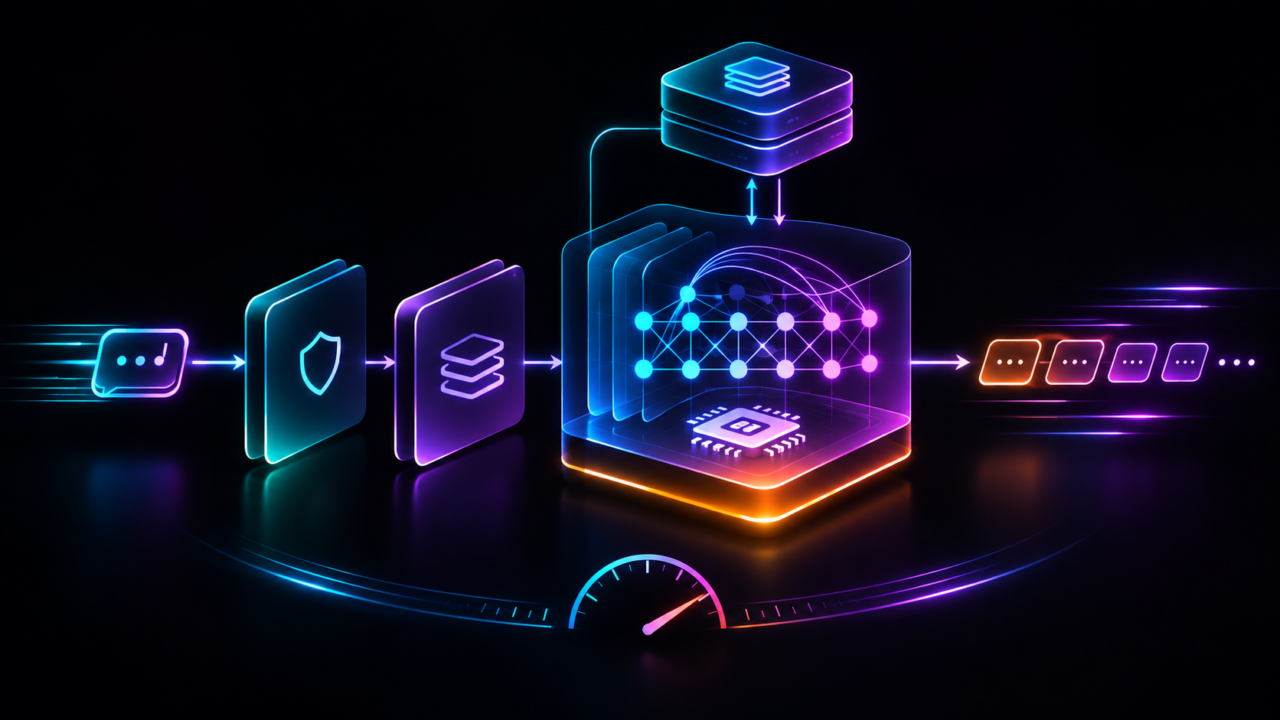
A inferência de Large Language Models em produção é um problema de engenharia de sistemas distribuídos, gerenciamento de memória e otimização de recursos computacionais. Entre o recebimento de uma requisição HTTP e a entrega de tokens ao usuário, existe uma sequência de decisões que determina latência, throughput, confiabilidade e custo operacional. O desempenho percebido depende tanto da execução do Transformer quanto da eficiência da infraestrutura responsável por disponibilizá-lo.
Diferentemente de workloads tradicionais de machine learning, LLM serving combina uma etapa de processamento intensivo do contexto com uma fase de geração autoregressiva, caracterizada por dependências sequenciais e pressão crescente sobre a memória. Essa assimetria altera o comportamento dos aceleradores, a capacidade de batching e a distribuição de recursos. Consequentemente, dimensionar GPUs exclusivamente pelo número de parâmetros do modelo produz estimativas insuficientes para aplicações empresariais.
Em ambientes de alta concorrência, decisões aparentemente locais apresentam consequências sistêmicas. Aumentar o batch size pode melhorar o throughput agregado enquanto compromete a latência individual. Expandir o KV Cache reduz recomputações, mas diminui a memória disponível para outras operações. Separar prefill e decode permite especialização de recursos, embora introduza comunicação distribuída, transferência de estado e novos modos de falha.
Este artigo examina a infraestrutura de inferência sob a perspectiva de Staff e Principal AI Engineering, conectando arquitetura, GPU scheduling, memory management, distributed inference, performance evaluation e economia computacional. O objetivo é estabelecer critérios técnicos para projetar sistemas capazes de atender Service Level Objectives previsíveis, controlar custos por token e preservar a qualidade das respostas sob cargas heterogêneas. Mais importante que maximizar benchmarks isolados é compreender quais decisões arquiteturais sustentam desempenho consistente em produção.
Fale comigo no LinkedIn: https://www.linkedin.com/in/celso-sousa/
1. Anatomia de uma requisição: do API Gateway ao Token Streaming
O ciclo de vida de uma requisição de LLM começa antes da execução de qualquer operação matricial. Uma infraestrutura de produção precisa autenticar o consumidor, aplicar políticas de utilização, selecionar modelos, validar parâmetros e determinar se existe capacidade suficiente para admitir o processamento. Essas operações integram o caminho crítico da inferência e precisam ser consideradas na definição do orçamento total de latência.
Após o admission control, a requisição atravessa etapas de normalização, construção do prompt, tokenization e roteamento até um inference worker. Dependendo da arquitetura, o processamento pode acontecer em uma única GPU, em múltiplos aceleradores com tensor parallelism ou em pools especializados para prefill e decode. Cada configuração altera a distribuição de custos entre CPU, memória, comunicação e processamento paralelo.
Durante o prefill, o modelo processa os tokens do contexto e constrói representações intermediárias utilizadas na geração. Em seguida, o decode produz tokens autoregressivamente, atualizando o KV Cache e transmitindo fragmentos ao consumidor. A entrega pode utilizar Server-Sent Events, mas a presença de streaming não garante baixa latência. Congestionamento, buffering intermediário e scheduling inadequado podem comprometer a experiência mesmo quando o modelo apresenta boa velocidade computacional.
Para compreender esse caminho, é necessário distinguir tempo de processamento, espera em filas e transporte de dados. Uma requisição pode apresentar execução eficiente na GPU e, simultaneamente, elevado Time to First Token por causa de contenção no scheduler. O desenho arquitetural deve permitir medir esses componentes separadamente, identificar seus gargalos e relacioná-los às características do workload. Essa decomposição constitui a base para qualquer estratégia de performance engineering em LLM serving.
1.1. Request lifecycle: autenticação, admission control, model routing e construção do contexto
O API Gateway de uma plataforma de LLM serving precisa executar funções superiores ao encaminhamento HTTP. Autenticação, autorização, rate limiting e controle de quotas devem operar antes da alocação de recursos computacionais. Em ambientes multi-tenant, esses mecanismos precisam considerar não apenas requisições por segundo, mas também tokens de entrada, tokens de saída estimados e consumo concorrente de memória associado aos contextos ativos.
O admission control representa uma decisão de capacidade. Admitir indiscriminadamente novas requisições pode provocar crescimento das filas, saturação do KV Cache e aumento descontrolado da tail latency. Uma estratégia robusta combina limites de concorrência, estimativas de utilização, deadlines e políticas explícitas de rejeição. Quando a capacidade disponível é insuficiente, responder rapidamente com overload control pode produzir maior confiabilidade que permitir timeouts generalizados.
O model routing adiciona outra dimensão. Requisições podem exigir modelos distintos, adaptadores LoRA específicos ou diferentes restrições de latência. O roteador precisa conhecer compatibilidade, disponibilidade e localização dos caches. Distribuir tráfego apenas por round-robin ignora assimetrias no tamanho dos prompts, no estado dos workers e na capacidade efetiva de processamento. Cache-aware routing pode melhorar reutilização de prefixos, desde que não concentre excessivamente a carga.
A construção do contexto também exige disciplina arquitetural. System prompts, documentos recuperados, histórico conversacional e resultados de ferramentas aumentam o número de tokens processados. O serviço deve aplicar token budgets, validar limites contextuais e preservar isolamento entre tenants. Na prática, o contrato entre application layer e inference layer precisa transmitir metadados suficientes para realizar scheduling eficiente sem expor informações confidenciais desnecessárias.
1.2. Tokenization, chat templates e processamento no CPU: custos ocultos antes da execução na GPU
Tokenization frequentemente recebe pouca atenção em avaliações de LLM inference, embora integre diretamente o caminho crítico. Antes da execução do Transformer, o texto precisa ser convertido em identificadores de tokens compatíveis com o vocabulário e a versão do modelo. O custo depende do tamanho do prompt, do algoritmo de tokenização, da implementação utilizada e da concorrência existente sobre os recursos de CPU.
Em arquiteturas de serving com alto throughput, CPU preprocessing pode se tornar gargalo mesmo quando existe capacidade ociosa na GPU. Serialização JSON, aplicação de chat templates, validação de parâmetros, preparação multimodal e construção de attention metadata consomem ciclos computacionais. Sob carga elevada, contenção entre threads, alocações de memória e pressão sobre o garbage collector de componentes intermediários podem produzir variações relevantes de latência.
Chat templates representam também um contrato de correção. Alterações em tokens especiais, delimitadores de mensagens ou formatos de tool calling podem modificar o comportamento do modelo sem qualquer mudança nos pesos. Portanto, tokenizer revision, template version e serving configuration devem integrar o versionamento da implantação. Uma inconsistência entre componentes pode comprometer prefix caching, contagem de tokens e avaliação de resultados.
A otimização exige observar CPU utilization, run queues, tempo de tokenization e custo de serialização por requisição. Separar API workers de processos computacionais, utilizar tokenizers eficientes e reduzir transformações redundantes são estratégias relevantes. Entretanto, ampliar indiscriminadamente o número de processos pode aumentar contenção e consumo de memória. A configuração adequada depende de profiling e análise da relação entre capacidade de preprocessing e velocidade de admissão da GPU.
1.3. O caminho crítico: request queue, prefill, decode, detokenization e streaming via SSE
A execução efetiva de uma requisição envolve estágios com características computacionais diferentes. Inicialmente, o scheduler posiciona o trabalho em uma fila e determina quando existem recursos para executá-lo. Durante o prefill, os tokens do contexto são processados e suas representações de key e value são materializadas. Posteriormente, a fase de decode utiliza esse estado para calcular probabilidades condicionais e selecionar novos tokens sequencialmente.
A separação entre essas etapas é fundamental porque seus tempos respondem de maneiras distintas ao aumento da carga. Prefill tende a concentrar operações matriciais sobre múltiplos tokens, enquanto decode frequentemente enfrenta limitações de bandwidth e reutilização de pesos. Quando essas operações compartilham recursos, requisições com contextos extensos podem interferir diretamente na cadência de geração de outras sequências em andamento.
Após a seleção de tokens, a infraestrutura executa detokenization incremental e transmite eventos ao cliente. Em SSE, cada evento pode conter um fragmento textual, metadados ou informações de conclusão. Entretanto, tokens internos e fragmentos transmitidos não possuem correspondência necessariamente unitária. Caracteres Unicode, buffering e escolhas de implementação podem exigir agregação antes da apresentação de texto válido ao consumidor.
Uma análise rigorosa identifica timestamps para chegada, admissão, início do prefill, primeiro token produzido, primeiro byte enviado e conclusão da resposta. Também diferencia o tempo observado pelo inference engine daquele percebido pelo cliente. Proxy buffering, políticas de flush e congestionamento de rede podem distorcer medições. Sem essa instrumentação, otimizações computacionais podem apresentar ganhos expressivos em laboratório e benefícios irrelevantes na experiência real do usuário.
1.4. Decomposição do latency budget: TTFT, TPOT, end-to-end latency e amplificação de latência entre serviços
O latency budget de uma aplicação com LLM precisa representar a composição das etapas do caminho crítico. Time to First Token mede o intervalo até a primeira emissão observável, enquanto Time per Output Token descreve a velocidade média de geração após o primeiro token. Inter Token Latency caracteriza os intervalos entre emissões sucessivas. Essas métricas representam dimensões complementares e não devem ser substituídas exclusivamente pela latência total.
Para uma requisição com N tokens de saída, uma aproximação operacional é considerar o tempo total como TTFT mais a soma dos intervalos necessários para produzir os N menos um tokens restantes. Entretanto, a relação pode variar com buffering, token aggregation e instrumentação. Além disso, TTFT inclui parcelas de transporte, filas, preprocessing e prefill que precisam ser isoladas para identificar a origem de regressões.
Em aplicações agentic, o problema torna-se mais complexo. Uma resposta pode depender de retrieval, reranking, chamadas de ferramentas e múltiplas inferências sequenciais. A latência end-to-end deixa de ser determinada apenas pelo modelo e passa a depender do critical path do workflow. Componentes paralelos contribuem pelo maior tempo de conclusão, enquanto componentes sequenciais acumulam suas durações e ampliam a exposição a tail latency.
O planejamento deve estabelecer SLOs por categoria de workload, diferenciando experiências interativas, geração extensa e tarefas assíncronas. Também deve reservar margens para variação de rede, cold starts e contenção. Uma arquitetura eficiente não maximiza isoladamente a velocidade de geração: distribui o orçamento de latência entre componentes com base em medições, dependências e impacto efetivo sobre a experiência do consumidor.
2. Dentro da GPU: como o modelo transforma tokens em inferência autoregressiva
O desempenho de um inference engine depende da relação entre operações matemáticas, movimentação de dados e utilização dos recursos físicos da GPU. A execução de um Transformer envolve multiplicações matriciais, normalizações, mecanismos de atenção e operações de seleção de tokens. Entretanto, o custo de cada etapa não pode ser interpretado exclusivamente pelo número de operações de ponto flutuante. Memory bandwidth, capacidade de cache e eficiência dos kernels frequentemente determinam o desempenho efetivo.
Uma GPU moderna apresenta unidades especializadas para processamento matricial, memória de alta largura de banda e uma hierarquia de armazenamento com diferentes capacidades e latências. O desafio consiste em maximizar a reutilização dos dados antes de movimentá-los novamente pela hierarquia. Em determinados workloads, o acelerador permanece limitado pela capacidade computacional. Em outros, os núcleos ficam subutilizados aguardando a transferência de pesos e estados intermediários.
A inferência autoregressiva intensifica esse problema porque cada token gerado depende dos tokens anteriores. Embora múltiplas requisições possam ser processadas conjuntamente, os passos de geração de uma mesma sequência permanecem causalmente dependentes. Essa característica torna batching, caching e scheduling elementos inseparáveis da execução matemática. O desempenho de um modelo isolado não representa necessariamente sua eficiência quando compartilhado por centenas de requisições concorrentes.
Para dimensionar corretamente a infraestrutura, é necessário compreender a interação entre arquitetura do modelo e arquitetura do hardware. Attention variants, quantization, estratégias de paralelismo e distribuição do KV Cache alteram o perfil de utilização dos aceleradores. A configuração ótima deve ser determinada por medições de compute utilization, memória transferida, throughput sustentado e latência sob o workload real, não apenas por características nominais da GPU.
2.1. Prefill versus decode: compute-bound, memory-bound e limites impostos pelo Roofline Model
Prefill e decode apresentam perfis de desempenho fundamentalmente diferentes. Durante o prefill, o modelo processa múltiplos tokens do contexto em operações matriciais relativamente grandes, permitindo maior reutilização dos pesos e melhor ocupação das unidades computacionais. Durante o decode, a geração de um novo token exige percorrer sucessivamente as camadas do Transformer, frequentemente com menor intensidade aritmética por requisição.
O Roofline Model fornece uma interpretação quantitativa dessa diferença. O desempenho sustentado é limitado pelo menor valor entre a capacidade computacional máxima e o produto da largura de banda de memória pela intensidade aritmética. Em termos operacionais, arithmetic intensity representa a quantidade de operações executadas por byte movimentado. Quando essa relação é baixa, ampliar FLOPS disponíveis pode produzir ganhos pequenos se o sistema continuar limitado pelo acesso à memória.
Prefill costuma apresentar maior tendência a regimes compute-bound, particularmente com sequências suficientemente extensas e kernels eficientes. Decode com baixa concorrência frequentemente permanece memory-bound devido ao custo de leitura dos pesos e do KV Cache. Entretanto, essas classificações não são universais. Batch size, comprimento contextual, quantization e implementação dos kernels podem deslocar significativamente o ponto de operação no Roofline.
Essa distinção orienta decisões práticas. Aumentar batching pode elevar arithmetic intensity durante decode, mas também aumenta pressão sobre memória e latência de scheduling. Reduzir precisão dos pesos diminui tráfego de memória, embora introduza operações de desquantização. Uma avaliação Staff-level deve identificar o recurso efetivamente saturado antes de escolher a otimização. Sem essa evidência, investimentos em aceleradores mais potentes podem simplesmente transferir o gargalo para outra parte da arquitetura.
2.2. Attention kernels, FlashAttention, GQA e MLA: implicações para compute efficiency e memory bandwidth
O mecanismo de atenção influencia diretamente a quantidade de computação e o volume de dados movimentados durante inferência. Implementações ingênuas podem materializar grandes matrizes intermediárias de attention scores, provocando tráfego excessivo entre memória global e armazenamento rápido da GPU. FlashAttention reduz esse problema utilizando tiling e reorganização computacional para executar operações de atenção exata com maior eficiência de acesso à memória.
Entretanto, FlashAttention não elimina os custos associados ao comprimento contextual. Durante prefill, o processamento de sequências extensas continua exigindo atenção causal e operações computacionais significativas. Durante decode, o desafio dominante pode ser acessar eficientemente keys e values acumulados. Por isso, kernels otimizados para processamento de contexto e kernels especializados em geração incremental frequentemente apresentam estratégias distintas de execução.
Grouped Query Attention, ou GQA, reduz a quantidade de cabeças independentes de key e value compartilhando esses estados entre grupos de query heads. Essa escolha diminui o footprint do KV Cache e o volume de leitura durante decode. Multi-head Latent Attention, ou MLA, utiliza representações latentes comprimidas para reduzir custos de armazenamento e movimentação, exigindo kernels compatíveis com sua estrutura matemática e seus mecanismos de projeção.
Essas alternativas envolvem trade-offs de arquitetura do próprio modelo, não apenas parâmetros de serving. É necessário avaliar qualidade preditiva, compatibilidade com kernels, precisão numérica e benefícios sob diferentes comprimentos contextuais. Uma implementação otimizada de GQA pode superar uma configuração teoricamente mais compacta quando esta depende de operações adicionais ou kernels menos eficientes. O critério final deve combinar desempenho real, qualidade das respostas e custo computacional por token.
2.3. KV Cache como recurso crítico: PagedAttention, fragmentação, alocação dinâmica e memory pressure
O KV Cache armazena representações intermediárias utilizadas para evitar recomputar integralmente o contexto a cada token gerado. Em arquiteturas Transformer com atenção autoregressiva, seu consumo cresce com o número de camadas, comprimento da sequência, quantidade de KV heads, dimensão das cabeças e precisão utilizada. Uma aproximação para seu tamanho é 2 × layers × sequence length × KV heads × head dimension × bytes por elemento.
Essa relação demonstra por que context windows extensas modificam radicalmente o capacity planning. Mesmo quando os pesos do modelo cabem confortavelmente na GPU, centenas de sequências simultâneas podem esgotar a memória destinada aos estados de atenção. Como o comprimento efetivo varia entre requisições, pré-alocar buffers contíguos para o tamanho máximo produz desperdício e limita a concorrência admissível.
PagedAttention introduz gerenciamento por blocos, permitindo armazenar os estados em regiões físicas não necessariamente contíguas. O mecanismo separa a organização lógica das sequências da alocação efetiva de memória, reduzindo desperdício decorrente de reservas excessivas e facilitando compartilhamento de prefixos. Entretanto, blocos ainda possuem fragmentação interna, e suas tabelas de mapeamento introduzem custos administrativos e exigências específicas dos attention kernels.
Em produção, KV Cache management deve acompanhar utilização de blocos, taxas de alocação, prefix reuse e frequência de preemption. Aumentar a fração de VRAM reservada ao cache pode elevar concorrência, mas reduzir espaço disponível para buffers de execução e operações auxiliares. O dimensionamento correto considera distribuição contextual, crescimento durante geração e capacidade de recuperação diante de pressão de memória. Cache é, portanto, um recurso de scheduling, não apenas uma otimização matemática.
2.4. Tensor, Pipeline e Expert Parallelism: custos de comunicação, sincronização e topologia entre GPUs
Modelos que excedem a capacidade de uma GPU exigem estratégias de distribuição, mas cada forma de paralelismo modifica o caminho crítico da inferência. Tensor Parallelism particiona operações matriciais entre aceleradores e introduz comunicação coletiva para combinar resultados. Dependendo da arquitetura, operações como all-reduce e all-gather podem ocorrer repetidamente ao longo das camadas, tornando interconnect bandwidth e latency componentes relevantes do desempenho.
Pipeline Parallelism distribui grupos de camadas entre dispositivos. Essa configuração reduz a necessidade de determinados coletivos, mas cria dependências entre estágios e possíveis pipeline bubbles. Com batches pequenos ou geração incremental, manter todos os estágios ocupados torna-se particularmente difícil. O desempenho depende do balanceamento entre partições, da granularidade de processamento e da quantidade de trabalho disponível para sobrepor comunicação e computação.
Em modelos Mixture of Experts, Expert Parallelism distribui especialistas entre GPUs e utiliza mecanismos de comunicação para encaminhar tokens aos experts selecionados. Essa arquitetura adiciona desafios de load balancing, pois a distribuição dos tokens pode variar significativamente entre requisições. Hot experts e tráfego all-to-all podem provocar contenção mesmo quando a utilização computacional média aparenta estar equilibrada.
A seleção do paralelismo deve considerar a topologia física. Comunicação entre GPUs conectadas por NVLink apresenta características diferentes de transferências entre nós via rede. Aumentar o número de dispositivos pode reduzir memória por rank, mas elevar sincronizações e custo total. Uma análise arquitetural adequada compara throughput por GPU, latência incremental, consumo de rede e capacidade de recuperação. O objetivo não é maximizar paralelismo, mas encontrar a menor configuração distribuída capaz de cumprir os SLOs.
3. Scheduling e concorrência: como preservar baixa latência sob cargas reais
GPU scheduling em LLM serving representa um problema de alocação dinâmica de recursos sob dependências sequenciais e demandas heterogêneas. Requisições chegam com contextos de tamanhos diferentes, produzem respostas de comprimentos imprevisíveis e competem por computação, largura de banda e memória. Como uma mesma GPU pode executar múltiplas sequências, a política de escalonamento influencia diretamente o throughput agregado e a experiência individual.
Ao contrário de workloads com tarefas homogêneas, a duração de uma inferência não é conhecida integralmente no momento da admissão. O comprimento final depende da geração, dos critérios de parada e das condições de execução. O scheduler precisa, portanto, tomar decisões incrementais, considerando sequências ativas, novos prompts, disponibilidade de KV blocks e prioridades de atendimento. Essas decisões afetam também a previsibilidade de latência.
Políticas orientadas exclusivamente ao aproveitamento dos aceleradores podem produzir comportamentos inadequados em aplicações interativas. Por exemplo, admitir um grande volume de prefill pode elevar utilização computacional, mas interromper a progressão regular das requisições que já estão gerando tokens. O resultado é maior throughput potencial acompanhado de degradação na cadência do streaming e aumento da latência de cauda.
A engenharia de scheduling deve estabelecer objetivos explícitos: minimizar TTFT, preservar ITL, maximizar goodput ou assegurar fairness entre classes de serviço. Esses objetivos frequentemente competem entre si. Uma arquitetura madura utiliza telemetria e experimentos controlados para avaliar políticas de batching, preemption e prioridade sob distribuições realistas de tráfego. O scheduler deixa de ser um detalhe interno do inference engine e passa a representar uma decisão central de system design.
3.1. Continuous batching e iteration-level scheduling: maximização de GPU utilization sem comprometer SLOs
Static batching agrupa requisições antes do processamento e pode manter recursos ocupados por sequências com durações distintas. Quando uma geração termina antecipadamente, parte da capacidade reservada deixa de produzir trabalho útil. Continuous batching modifica essa dinâmica permitindo que o conjunto de sequências executadas seja atualizado entre iterações, adicionando novas requisições e removendo aquelas que já foram concluídas.
O benefício principal está na utilização mais eficiente da capacidade computacional e da memória disponível. Em vez de aguardar a conclusão do batch inteiro, o scheduler reorganiza o trabalho continuamente. Entretanto, a implementação precisa respeitar limites de tokens processados por iteração, número máximo de sequências e disponibilidade de KV blocks. A simples ampliação da concorrência não assegura melhoria proporcional de desempenho.
Batching altera também a intensidade aritmética do decode. Ao processar mais sequências simultaneamente, a execução consegue amortizar parte do custo de leitura dos pesos. Porém, cada sequência adicional demanda seu próprio estado contextual e aumenta a pressão sobre o KV Cache. Quando o sistema ultrapassa determinado ponto de saturação, TTFT e ITL podem crescer rapidamente, reduzindo a quantidade de respostas concluídas dentro dos SLOs.
A avaliação deve produzir curvas relacionando offered load, active sequences, throughput e latência por percentil. O ponto operacional desejável normalmente está antes da saturação extrema, preservando headroom para bursts. Uma estratégia Staff-level prioriza goodput sob restrições de serviço, não utilização máxima da GPU. O melhor batch size efetivo é aquele que equilibra eficiência computacional, disponibilidade de memória e estabilidade da latência durante variações de demanda.
3.2. Chunked prefill, token budgets e interferência entre requisições com diferentes context lengths
Prefill de contextos extensos pode monopolizar recursos computacionais durante períodos significativos. Quando uma requisição processa dezenas de milhares de tokens, outras sequências podem enfrentar atrasos mesmo possuindo poucos tokens pendentes. Chunked prefill reduz essa interferência ao particionar o processamento do contexto em unidades menores, que podem ser intercaladas com operações de decode de requisições já ativas.
A técnica melhora a flexibilidade do scheduler, mas introduz decisões sobre granularidade. Chunks grandes favorecem operações matriciais eficientes e amortização de overhead, enquanto chunks menores aumentam as oportunidades de execução intercalada. A escolha influencia tanto o TTFT das novas requisições quanto o ITL das sequências em geração. Não existe um tamanho universalmente ideal para todas as distribuições de contexto.
Token budgets por iteração permitem limitar a quantidade total de trabalho admitido em cada ciclo. Entretanto, tokens de prefill e decode apresentam perfis computacionais diferentes. Tratá-los como unidades de custo equivalentes pode resultar em estimativas imprecisas de duração. Um scheduler mais sofisticado pode considerar comprimento contextual, características dos kernels e pressão de memória para aproximar o custo efetivo de cada decisão.
A avaliação deve incluir workloads bimodais, combinando prompts curtos com contextos extensos, além de chegadas em rajadas. É importante medir a interferência entre classes, não apenas resultados agregados. Um aumento no throughput médio pode ocultar degradações severas para requisições interativas. Em produção, chunked prefill deve ser parametrizado com base em objetivos explícitos de isolamento de latência, eficiência computacional e previsibilidade operacional.
3.3. Preemption, recomputation e KV Cache eviction: decisões de escalonamento sob pressão de memória
Quando a memória destinada ao KV Cache se aproxima do limite, o scheduler precisa decidir quais sequências permanecem residentes. Preemption permite interromper temporariamente uma requisição para liberar recursos e continuar outras operações. Entretanto, remover uma sequência da execução não elimina sua necessidade futura de estado contextual. O sistema precisa preservar esse estado ou reconstruí-lo quando a requisição for retomada.
Uma estratégia é recomputation, na qual o contexto necessário é novamente processado para recuperar as representações intermediárias. Outra possibilidade envolve transferir estados para níveis de memória mais lentos, dependendo das capacidades do inference engine. Essas alternativas trocam consumo de memória por computação ou transferência de dados. O custo relativo depende do comprimento contextual, bandwidth disponível e frequência de interrupção.
KV Cache eviction também afeta prefix caching. Blocos reutilizáveis podem competir com estados ativos por capacidade limitada. Preservar prefixos populares aumenta cache hit ratio, mas pode reduzir espaço para novas sequências. Políticas de eviction precisam considerar frequência, recência, tamanho e custo de reconstrução, além de restrições de isolamento. Um cache hit não representa automaticamente economia quando sua manutenção provoca preemption adicional.
A observabilidade deve distinguir waiting time, recomputed tokens, evicted blocks e overhead de recuperação. Oscilações repetidas entre admissão e preemption indicam instabilidade na política de scheduling ou excesso de carga. O admission control deve reagir antes que esses ciclos comprometam a infraestrutura. Em vez de tratar memory pressure como evento excepcional, arquiteturas robustas incorporam seus custos ao capacity planning e às políticas de proteção contra sobrecarga.
3.4. Head-of-line blocking, priority scheduling e fairness: controle de tail latency em workloads heterogêneos
Head-of-line blocking ocorre quando uma unidade de trabalho retarda outras que poderiam progredir independentemente. Em LLM serving, esse fenômeno pode aparecer nas filas de admissão, durante operações extensas de prefill ou em políticas que favorecem determinados grupos de requisições. O impacto é particularmente relevante quando workloads interativos compartilham recursos com geração extensa ou processamento assíncrono.
Priority scheduling permite diferenciar classes de serviço, atribuindo tratamento preferencial a requisições com deadlines mais restritivos. Entretanto, prioridade absoluta pode produzir starvation para tráfego de menor importância. Uma política eficiente precisa combinar prioridades com mecanismos de fairness, como weighted scheduling, aging ou controle de quotas. A escolha depende dos contratos comerciais e dos objetivos de disponibilidade da plataforma.
Fairness também exige definir a unidade de consumo. Distribuir igualmente requisições não garante justiça quando uma delas utiliza mil tokens e outra processa centenas de milhares. Quotas baseadas em tokens são mais representativas, mas ainda não capturam integralmente diferenças de custo entre prefill, decode e tamanhos contextuais. Modelos de cobrança e admissão podem incorporar unidades ponderadas de capacidade, calibradas empiricamente.
O monitoramento deve apresentar métricas segmentadas por tenant, workload e prioridade. Percentis agregados podem ocultar situações em que uma classe recebe serviço excelente enquanto outra enfrenta degradação contínua. É necessário avaliar starvation, deadline misses e variação do tempo de espera sob sobrecarga. Uma arquitetura de inferência madura não busca apenas baixo P99 global. Ela estabelece garantias operacionais coerentes com diferentes perfis de consumidores e evita que otimizações locais comprometam a previsibilidade do sistema compartilhado.
4. System Design para LLM Serving distribuído em produção
A arquitetura de LLM serving distribuído precisa coordenar recursos computacionais, memória e comunicação sob requisitos simultâneos de baixa latência e alta disponibilidade. Diferentemente de serviços stateless convencionais, inference workers mantêm estados transitórios relevantes para a execução, especialmente o KV Cache. Essa característica torna decisões de roteamento, replicação e recuperação mais complexas que o simples balanceamento de requisições HTTP.
O desenho da plataforma começa pela separação de responsabilidades entre control plane e data plane. O control plane administra configuração, descoberta de serviços, políticas de capacidade e implantação de modelos. O data plane executa requisições, movimenta estados e transmite tokens. Essa separação facilita evolução operacional, mas exige contratos explícitos para compatibilidade de versões, gerenciamento de recursos e tratamento de falhas.
Uma arquitetura distribuída também precisa decidir onde executar cada etapa da inferência. Colocar prefill e decode no mesmo worker reduz comunicação e simplifica gerenciamento de memória. Distribuí-los em pools independentes permite otimizar cada fase separadamente. Entretanto, essa especialização introduz transferência de estados, sincronização e possíveis desequilíbrios de capacidade entre componentes.
Em escala, a eficiência depende da correspondência entre workload e topologia. Modelos grandes, contextos extensos e alta concorrência podem exigir configurações distintas de paralelismo e recursos. Além disso, políticas de rollout, autoscaling e failover precisam considerar o custo de inicialização dos modelos e a perda de caches residentes. System design para inferência exige, portanto, uma abordagem integrada de compute scheduling, memory placement, network topology, observability e reliability engineering, evitando otimizações isoladas que apenas deslocam gargalos entre serviços.
4.1. Arquiteturas colocated versus disaggregated serving: separação de prefill, decode e processamento no CPU
Em arquiteturas colocated, um mesmo conjunto de workers executa prefill e decode, compartilhando pesos, memória e mecanismos de scheduling. Essa configuração reduz a necessidade de transferir o KV Cache entre dispositivos e frequentemente oferece menor complexidade operacional. Para modelos menores, tráfego moderado ou prompts curtos, a simplicidade pode representar uma vantagem expressiva em latência, custo e disponibilidade.
Disaggregated serving separa essas etapas em pools especializados. Workers de prefill podem priorizar throughput de processamento contextual, enquanto workers de decode são dimensionados para concorrência, bandwidth e capacidade de KV Cache. A separação permite utilizar diferentes graus de tensor parallelism e escalar os pools independentemente. Também reduz a interferência de prompts extensos sobre sequências que já estão gerando tokens.
Entretanto, a requisição passa a exigir um handoff entre serviços. O prefill precisa produzir um estado compatível com o decode worker, disponibilizar metadados de transferência e coordenar a movimentação de memória. Esse processo adiciona latência, comunicação e pontos de falha. Se o tempo economizado com especialização for inferior ao custo de transferência e coordenação, o resultado poderá ser pior que uma arquitetura colocated.
A decisão deve considerar a distribuição conjunta de input tokens, output tokens e concorrência. Workloads com prefill intenso e decode prolongado podem justificar separação, especialmente quando existe interconnect eficiente. Já sistemas com tráfego reduzido podem sofrer com capacidade fragmentada entre pools. A comparação precisa medir goodput, TTFT, ITL, utilização por GPU e custo total, incluindo infraestrutura de comunicação e capacidade ociosa reservada.
4.2. KV Cache transfer entre workers: RDMA, custo de comunicação, recomputation e cache locality
A transferência de KV Cache representa uma das operações mais sensíveis em arquiteturas disaggregated. Após o prefill, o decode worker precisa receber os estados necessários para continuar a geração sem recalcular integralmente o contexto. O volume transferido depende da arquitetura de atenção, comprimento da sequência, precisão numérica e grau de particionamento entre dispositivos. Contextos extensos podem produzir transferências relevantes mesmo quando a resposta gerada é curta.
Uma aproximação inicial para o custo de transferência combina o volume efetivo de dados dividido pela bandwidth sustentada com overhead de controle, inicialização e sincronização. Entretanto, throughput nominal da rede não representa necessariamente o desempenho obtido. Contenção entre fluxos, disposição dos buffers, topologia dos aceleradores e capacidade de sobreposição entre comunicação e computação influenciam o resultado.
Tecnologias como RDMA e GPUDirect RDMA podem reduzir intervenções da CPU e cópias intermediárias, permitindo transferências mais eficientes entre memória de aceleradores. Dentro de determinados servidores, NVLink pode oferecer um caminho de comunicação vantajoso. Em ambientes multinode, o desempenho depende também do fabric de rede, da configuração dos adaptadores e da proximidade física entre workers.
Cache locality modifica a economia dessa operação. Se um worker já possui parte do prefixo necessário, reutilizar o estado pode ser mais barato que transferi-lo novamente. Em outros cenários, recomputation parcial pode competir favoravelmente com uma transferência remota congestionada. A arquitetura precisa comparar custos reais por caminho, validar compatibilidade entre representações e estabelecer recuperação para handoffs incompletos. Transferir menos dados somente representa ganho quando não provoca recomputações ou sincronizações mais caras.
4.3. Cache-aware routing, request affinity e balanceamento orientado a capacidade efetiva
Load balancing convencional frequentemente utiliza round-robin, quantidade de conexões ou número de requisições ativas. Essas estratégias são insuficientes para LLM inference porque cada requisição apresenta custos distintos e os workers possuem estados de cache diferentes. Dois servidores com igual número de sequências podem apresentar capacidades efetivas muito diferentes devido ao comprimento contextual, tokens pendentes e quantidade de memória disponível.
Cache-aware routing incorpora a probabilidade de reutilização de prefixos na seleção do destino. Quando múltiplas requisições compartilham system prompts ou documentos comuns, encaminhá-las a workers com estados residentes pode reduzir prefill e consumo computacional. Entretanto, a afinidade excessiva pode concentrar tráfego em poucos dispositivos, provocar pressão de memória e aumentar waiting time, anulando o benefício da reutilização.
Uma política mais sofisticada estima o custo esperado de conclusão para cada worker. Essa estimativa pode combinar tokens de entrada não armazenados em cache, output length esperado, posição na fila, KV capacity e velocidade histórica sob determinada carga. A seleção deve considerar ainda penalidades de transferência entre workers e restrições de topologia. O objetivo é minimizar latência prevista sem criar desequilíbrios persistentes.
O roteamento precisa ser atualizado com sinais operacionais suficientemente recentes. Informações atrasadas podem levar diversos routers a escolher simultaneamente o mesmo worker, criando oscilações de carga. Técnicas de hysteresis, smoothing e limites de afinidade ajudam a estabilizar decisões. Em produção, o algoritmo deve ser avaliado por cache hit ratio, distribuição da utilização e tail latency. Maximizar localidade isoladamente pode reduzir a eficiência global da plataforma.
4.4. Distributed inference com vLLM, SGLang, TensorRT-LLM e Dynamo: critérios de seleção arquitetural
A seleção de um inference stack exige diferenciar engines de execução, mecanismos de scheduling e plataformas de orquestração. vLLM oferece recursos de serving associados a gerenciamento paginado de KV Cache, batching contínuo e otimizações de execução. SGLang enfatiza runtime eficiente, reutilização de prefixos e recursos voltados a workloads de geração estruturada. TensorRT-LLM disponibiliza implementações e otimizações especializadas para inferência, com forte integração ao ecossistema de hardware NVIDIA.
NVIDIA Dynamo atua em uma camada arquitetural distinta, oferecendo componentes para roteamento, coordenação distribuída e disaggregated serving sobre backends compatíveis. Portanto, uma comparação exclusivamente entre nomes de frameworks pode produzir conclusões incorretas. Algumas soluções executam modelos diretamente, enquanto outras coordenam múltiplos engines e serviços. A escolha precisa considerar a composição completa da plataforma.
Os critérios relevantes incluem suporte à arquitetura do modelo, attention kernels, quantization, speculative decoding, paralelismo e mecanismos de KV Cache transfer. Também devem ser avaliadas compatibilidade de versões, maturidade dos recursos utilizados, estratégias de observabilidade e facilidade de recuperação operacional. Recursos experimentais precisam de validação específica antes de integrar workloads críticos.
Uma avaliação reproduzível utiliza o mesmo modelo, precisão, hardware, distribuição de prompts e política de geração sempre que tecnicamente possível. Diferentes defaults de scheduler ou memory allocation devem ser explicitados. A comparação precisa contemplar TTFT, ITL, goodput, custo por token e estabilidade sob saturação. A decisão Staff-level não deve privilegiar popularidade ou benchmarks divulgados isoladamente, mas evidências sobre desempenho, integração e custo de manutenção para o ambiente operacional pretendido.
5. Otimizações avançadas: reduzindo o custo computacional por token gerado
A otimização de LLM inference deve ser tratada como um problema de redução do custo efetivo de processamento, e não apenas de aceleração de operações individuais. Cada token gerado consome recursos computacionais, largura de banda e capacidade de memória. Entretanto, essas despesas podem ser reduzidas por diferentes mecanismos, incluindo reutilização de trabalho anterior, diminuição da precisão numérica e reorganização da execução.
Prefix caching evita repetir determinadas operações de prefill. Quantization reduz representação de pesos e estados, alterando o perfil de memória e computação. Speculative decoding busca produzir múltiplos tokens aceitos com menos passos sequenciais do modelo principal. CUDA Graphs e kernel fusion procuram diminuir overhead de execução. Essas técnicas atuam em dimensões diferentes e frequentemente apresentam interações relevantes.
Uma otimização eficiente em baixa concorrência pode perder vantagem quando o batch size aumenta. Da mesma forma, reduzir memória por token pode ampliar a quantidade de requisições simultâneas, mas provocar regressões de qualidade ou overhead adicional de desquantização. Portanto, ganhos individuais não devem ser simplesmente somados para projetar o benefício de uma configuração combinada.
A metodologia adequada envolve estabelecer baseline, identificar gargalos dominantes, modificar um conjunto controlado de parâmetros e medir efeitos sobre desempenho e qualidade. Também é necessário considerar requisitos de segurança, isolamento e comportamento sob falhas. Em sistemas empresariais, o custo marginal de uma otimização inclui sua complexidade operacional, compatibilidade futura e impacto na capacidade de depuração. O objetivo arquitetural consiste em reduzir o custo por resposta útil dentro dos SLOs, preservando comportamento funcional e previsibilidade de execução.
5.1. Prefix caching e reutilização de KV Cache: cache hit ratio, invalidação e isolamento entre tenants
Prefix caching permite reutilizar estados de atenção previamente calculados quando novas requisições compartilham um prefixo compatível de tokens. Em aplicações empresariais, system prompts, instruções de agentes e documentos comuns podem gerar oportunidades relevantes de reutilização. O benefício depende do volume de prefill evitado, do custo de manutenção do cache e da probabilidade de futuras requisições utilizarem os mesmos blocos.
A identificação precisa considerar a sequência exata de tokens e os elementos que determinam a validade do estado. Modelo, configuração de atenção, posicionamento dos tokens e determinadas condições de execução podem invalidar a reutilização. Comparar apenas texto superficialmente semelhante não fornece garantia de compatibilidade. Em implementações com hashing de blocos, metadados adicionais podem ser incorporados à identificação dos prefixos.
O gerenciamento também envolve eviction e capacidade limitada. Preservar todos os blocos utilizados anteriormente pode reduzir espaço disponível para sequências ativas, provocando preemption ou rejeição de novas requisições. A política ideal precisa estimar valor de reutilização versus custo de retenção. Métricas como reused tokens, hit ratio ponderado pelo tamanho e memória ocupada são mais informativas que uma contagem simples de acertos.
Em plataformas multi-tenant, cache sharing exige atenção especial à confidencialidade. Mesmo quando os estados não expõem diretamente o texto original, padrões de compartilhamento e diferenças temporais podem criar riscos de isolamento. Cache salting, segregação lógica e políticas de acesso devem acompanhar os requisitos de segurança. A arquitetura deve demonstrar não apenas que o cache acelera o prefill, mas que sua utilização preserva correção, governança e fronteiras entre consumidores.
5.2. Quantization FP8, FP4 e INT4: trade-offs entre precisão numérica, bandwidth, memória e qualidade das respostas
Quantization reduz a precisão utilizada para representar pesos, ativações ou estados intermediários do modelo. O objetivo pode incluir diminuir memory footprint, reduzir transferência de dados e aproveitar operações especializadas do hardware. Entretanto, os benefícios dependem da combinação entre formato numérico, estratégia de quantização, suporte dos kernels e características do workload. Reduzir bits por parâmetro não garante aceleração proporcional.
FP8 utiliza formatos de ponto flutuante com menor precisão e diferentes características de faixa dinâmica. FP4 e INT4 permitem representações ainda mais compactas, mas frequentemente exigem mecanismos específicos de scaling, calibração e desquantização. Técnicas weight-only apresentam comportamento distinto de estratégias que também quantizam ativações. O impacto sobre a execução depende de quais tensores permanecem comprimidos durante os kernels.
Em workloads memory-bound, a redução do volume transferido pode melhorar significativamente o desempenho. Entretanto, quando operações adicionais de conversão dominam o caminho crítico ou o hardware não oferece execução eficiente para determinado formato, parte do benefício desaparece. Também é necessário avaliar separadamente a quantização do KV Cache, especialmente em contextos extensos, devido ao impacto acumulado sobre memória e precisão da atenção.
A validação funcional deve incluir tarefas sensíveis a erros numéricos, raciocínio de múltiplas etapas, geração estruturada e uso de ferramentas. Métricas agregadas podem ocultar regressões em casos críticos. Comparações precisam controlar sampling, seeds quando aplicáveis, prompts e versões. Uma decisão de produção combina qualidade, TTFT, ITL, capacidade concorrente e custo por resposta útil. Quantization é uma alteração arquitetural com consequências estatísticas, não apenas uma configuração de compressão.
5.3. Speculative decoding: draft models, acceptance rate, overhead de verificação e ganhos reais de latência
Speculative decoding procura reduzir a quantidade de passos sequenciais executados pelo modelo principal durante a geração. Uma abordagem utiliza um draft model mais econômico para propor vários tokens, que posteriormente são verificados pelo target model. Quando a verificação utiliza um algoritmo probabilisticamente correto, a distribuição produzida pode ser preservada. Entretanto, essa garantia depende do procedimento específico e não se aplica automaticamente a qualquer aproximação especulativa.
O ganho depende da quantidade de tokens aceitos por ciclo e do custo necessário para produzi-los e verificá-los. Draft models excessivamente grandes podem consumir parte significativa da economia. Modelos muito diferentes do target podem apresentar baixa acceptance rate, provocando rejeições frequentes. A profundidade especulativa precisa equilibrar eficiência de verificação, probabilidade de aceitação e utilização adicional de memória.
O benefício também depende do regime operacional. Em baixa concorrência, reduzir passos autoregressivos pode melhorar diretamente a latência de uma requisição. Sob batching elevado, a execução especulativa pode competir com outras sequências por compute e KV capacity. Nesse cenário, maior velocidade individual não implica necessariamente aumento de throughput agregado. Estratégias baseadas em múltiplos candidatos ou mecanismos como EAGLE introduzem características adicionais de execução.
A avaliação precisa registrar accepted tokens por ciclo, overhead de drafting, custo de verification e impacto sobre ITL. Também deve comparar comportamento em diferentes temperaturas, tipos de tarefa e comprimentos de resposta. Para aplicações críticas, é necessário validar equivalência de distribuição quando prometida ou mensurar explicitamente diferenças de qualidade. Speculative decoding deve ser habilitado somente quando seus ganhos persistem sob a concorrência e os SLOs reais da plataforma.
5.4. CUDA Graphs, kernel fusion e otimização de execução: quando reduzir overhead supera aumentar FLOPS
Nem toda limitação de inferência está associada à capacidade matemática da GPU. Em operações pequenas e repetitivas, o overhead de lançamento de kernels, preparação de argumentos e coordenação com a CPU pode representar parcela significativa da duração total. Esse fenômeno é particularmente relevante durante decode com baixa concorrência, quando o trabalho computacional de cada iteração pode ser relativamente pequeno.
CUDA Graphs permite capturar e reproduzir sequências de operações, reduzindo determinados custos de lançamento. Entretanto, a técnica depende de condições específicas de execução, especialmente relacionadas à estabilidade de formas, endereços e recursos utilizados. Inference engines frequentemente precisam combinar graph capture com estratégias de padding, buckets ou caminhos alternativos para acomodar requisições dinâmicas. A captura também pode exigir memória adicional.
Kernel fusion reduz etapas intermediárias ao combinar operações que anteriormente exigiriam múltiplos kernels e movimentação de dados. Fusão de normalizações, operações elementwise e transformações pode diminuir overhead e tráfego de memória. Entretanto, kernels excessivamente complexos podem aumentar register pressure, reduzir occupancy e limitar a flexibilidade do scheduler. O ganho depende da relação entre operações fundidas e características físicas do acelerador.
A estratégia de profiling deve separar tempo efetivo de execução, kernel launch overhead, sincronizações e transferências de dados. Ferramentas de GPU profiling ajudam a identificar se o gargalo está na execução matemática ou na coordenação. Otimizações precisam ser comparadas em diferentes batch sizes e comprimentos de sequência. A melhoria mais relevante nem sempre vem de hardware com mais FLOPS, mas de reduzir trabalho administrativo e movimentações desnecessárias no caminho crítico.
6. Performance Engineering: avaliação reproduzível, observabilidade e SLOs
Performance engineering para LLM inference exige compreender a relação entre capacidade computacional, comportamento do workload e experiência efetiva do consumidor. Benchmarks isolados frequentemente apresentam números elevados de tokens por segundo, mas não demonstram necessariamente que a infraestrutura consegue sustentar esses resultados sob restrições de latência. Um sistema pode maximizar throughput enquanto acumula filas, viola deadlines e degrada a experiência de usuários interativos.
A avaliação precisa separar métricas de execução, métricas de serviço e indicadores de eficiência econômica. GPU utilization e memory bandwidth descrevem aspectos do consumo de recursos. TTFT e Inter Token Latency caracterizam a resposta percebida. Goodput representa a capacidade de entregar trabalho útil dentro de critérios operacionais. Essas dimensões precisam ser analisadas conjuntamente para evitar decisões baseadas em indicadores incompletos.
Workloads representativos devem incorporar distribuições realistas de context length, output length, concorrência e padrões temporais de chegada. Também precisam reproduzir prefix reuse, diferentes classes de prioridade e comportamento de cancelamento. Testes exclusivamente sintéticos podem ser úteis para diagnóstico de gargalos, mas frequentemente deixam de representar correlações importantes presentes em ambientes empresariais.
Uma disciplina madura de avaliação estabelece baselines reproduzíveis, configurações versionadas, instrumentação distribuída e critérios explícitos de aprovação. Mudanças de scheduler, quantization ou arquitetura de serving devem ser acompanhadas por experimentos capazes de distinguir ganhos reais de variações na carga. O objetivo não é demonstrar que determinada configuração apresenta resultados superiores em condições favoráveis. É produzir evidências confiáveis de que a nova arquitetura entrega maior eficiência operacional, preservando qualidade e SLOs sob diferentes regimes de utilização.
6.1. TTFT, ITL, TPOT, goodput e latência P95/P99: métricas que revelam a capacidade real de serving
Time to First Token mede o intervalo até a primeira emissão observável e representa um indicador central para aplicações interativas. Entretanto, valores baixos de TTFT não garantem streaming eficiente. Uma requisição pode começar rapidamente e sofrer longas pausas entre tokens. Por isso, Inter Token Latency e Time per Output Token precisam ser analisados separadamente, considerando suas definições operacionais e diferenças de agregação.
ITL descreve os intervalos entre emissões sucessivas, enquanto TPOT frequentemente representa uma média da duração da geração dividida pelos tokens produzidos após o primeiro. As métricas podem apresentar comportamentos diferentes quando existe variabilidade na cadência. Além disso, latência end-to-end inclui a conclusão integral da resposta. Comparar serviços sem controlar output length pode produzir interpretações equivocadas, mesmo quando o workload parece semelhante.
Goodput introduz uma perspectiva mais relevante para produção. Em vez de contar todos os tokens ou requisições processados, considera apenas o trabalho que satisfaz determinados critérios de serviço. Uma definição operacional pode exigir TTFT abaixo de um limite, ITL aceitável e conclusão dentro do deadline. Essa abordagem penaliza arquiteturas que aumentam throughput sacrificando a experiência individual.
Percentis P95 e P99 revelam comportamentos de cauda, mas precisam ser segmentados por classe de workload, comprimento contextual e prioridade. Um P99 agregado pode esconder degradações persistentes em grupos específicos. A análise também deve acompanhar error rate, cancellation rate e rejected requests. Excluir requisições malsucedidas das estatísticas pode criar uma percepção artificial de desempenho. A capacidade efetiva é determinada pelo trabalho concluído corretamente dentro dos contratos estabelecidos.
6.2. Benchmarking reproduzível: open-loop workloads, burstiness, distribuições de tokens e curvas de saturação
A construção de benchmarks reproduzíveis começa pela definição do modelo de chegada das requisições. Em testes closed-loop, novos pedidos frequentemente dependem da conclusão de operações anteriores ou da manutenção de uma concorrência fixa. Essa estratégia é útil para avaliar determinados regimes, mas pode reduzir artificialmente a taxa de chegada quando o sistema desacelera, ocultando problemas de saturação.
Open-loop benchmarking permite controlar a taxa de chegada independentemente do tempo de resposta. Essa característica facilita identificar o ponto em que a capacidade sustentada deixa de acompanhar a demanda oferecida. Entretanto, o gerador de carga precisa manter precisão temporal e evitar que limitações próprias distorçam os resultados. Distribuições de Poisson podem representar determinados padrões, mas traces reais são necessários para reproduzir burstiness e correlações operacionais.
Os datasets devem preservar distribuições de input tokens, output tokens, prefix overlap e parâmetros de geração. Utilizar somente prompts de tamanho fixo elimina variações importantes de prefill e KV Cache. Também é necessário controlar hardware, versões de drivers, kernels, tokenizer, modelo, precisão numérica e configuração do scheduler. Warmup, duração do experimento e políticas de descarte de medições precisam ser documentados.
A análise deve produzir curvas de throughput versus latência sob diferentes níveis de offered load, identificando o ponto de saturação e o comportamento das filas. Comparações precisam utilizar intervalos de confiança ou repetições suficientes para caracterizar variabilidade. Ferramentas como vLLM benchmarking e NVIDIA AIPerf podem apoiar a coleta. Entretanto, nenhuma ferramenta substitui um desenho experimental que represente corretamente os objetivos e restrições do sistema.
6.3. Distributed tracing e GPU profiling: atribuição causal de gargalos entre rede, CPU, scheduler e kernels
A observabilidade de LLM inference precisa conectar eventos distribuídos ao comportamento efetivo dos aceleradores. Métricas agregadas de GPU utilization são insuficientes para determinar por que determinada requisição apresentou latência elevada. A investigação exige decompor o caminho crítico em admission control, preprocessing, queue waiting, prefill, decode, transferência de KV Cache e entrega de tokens ao cliente.
Distributed tracing permite relacionar essas etapas por meio de identificadores de correlação. Cada requisição deve preservar metadados relevantes, como model version, tenant class, input length, output length e identificadores de workers. Entretanto, o rastreamento precisa evitar armazenar prompts ou conteúdo sensível desnecessariamente. Sampling adaptativo pode priorizar requisições lentas, erros e mudanças de comportamento sem produzir overhead excessivo.
No nível da GPU, profiling precisa identificar kernel execution time, memory throughput, occupancy, sincronizações e comunicação coletiva. Ferramentas como NVIDIA Nsight Systems e Nsight Compute oferecem perspectivas complementares sobre execução e utilização de recursos. Em configurações distribuídas, é necessário correlacionar timelines de CPU, GPU e rede, considerando diferenças entre relógios e overhead introduzido pela instrumentação.
Atribuição causal exige cuidado adicional. Uma elevação simultânea de TTFT e utilização de memória não demonstra automaticamente que o KV Cache produziu a regressão. A relação pode envolver aumento de contexto, mudanças no scheduler ou alterações na distribuição de tráfego. Experimentos controlados, comparação entre cohorts e intervenções específicas ajudam a identificar mecanismos responsáveis. Uma plataforma madura transforma telemetria em hipóteses verificáveis, evitando decisões baseadas exclusivamente em correlações observacionais.
6.4. Performance versus model quality: evaluation de regressões introduzidas por quantization, caching e decoding
Otimizações de inferência precisam preservar a qualidade funcional do sistema, mas essa propriedade não pode ser assumida apenas porque a arquitetura utiliza os mesmos pesos originais. Quantization pode introduzir diferenças numéricas, speculative decoding pode alterar comportamento quando utiliza verificações aproximadas e mudanças de implementação podem produzir divergências relacionadas à precisão ou ordem das operações. Cada otimização exige uma hipótese explícita sobre equivalência.
A avaliação deve combinar testes determinísticos, quando aplicáveis, com benchmarks estatísticos de comportamento. Para geração estruturada, métricas como schema validity, constraint compliance e tool-call correctness são importantes. Em aplicações RAG, groundedness, factual consistency e answer correctness precisam ser consideradas. Em tarefas de raciocínio, avaliações devem incluir casos difíceis, sensibilidade a pequenas perturbações e estabilidade em múltiplas execuções.
Experimentos pareados ajudam a reduzir variabilidade. O mesmo conjunto de prompts deve ser processado pelas configurações baseline e candidata, mantendo parâmetros comparáveis. Quando sampling introduz aleatoriedade, múltiplas execuções e análise de distribuição tornam-se necessárias. Intervalos de confiança, diferenças por categoria e critérios de não inferioridade permitem avaliar se regressões observadas permanecem dentro de limites previamente aceitos.
A análise também precisa incorporar desempenho. Uma configuração pode preservar accuracy média e aumentar significativamente a latência de casos complexos. Outra pode melhorar throughput enquanto compromete a confiabilidade de tool calling. A aprovação de produção deve exigir simultaneamente critérios de qualidade, latência e custo. O objetivo não é maximizar um indicador isolado, mas demonstrar que a otimização melhora o desempenho operacional sem introduzir regressões funcionais incompatíveis com os requisitos da aplicação.
7. Engenharia econômica, resiliência e decisões arquiteturais em escala
A sustentabilidade de uma plataforma de LLM inference depende da capacidade de converter recursos computacionais em respostas úteis com custo previsível. O investimento em GPUs representa apenas uma parcela da equação. Rede, armazenamento, energia, capacidade ociosa, observabilidade, engenharia operacional e recuperação de falhas também contribuem para o custo total. Uma arquitetura tecnicamente rápida pode apresentar economia desfavorável quando exige recursos excessivos para cumprir seus SLOs.
O dimensionamento deve considerar demanda média, picos de utilização e variabilidade do workload. Aumentar a capacidade instalada reduz riscos de saturação, mas eleva o custo de recursos subutilizados. Operar próximo ao limite melhora determinados indicadores de aproveitamento, porém amplia filas e tail latency. O ponto econômico adequado depende da relação entre custo marginal de capacidade, criticidade do serviço e consequências de violações contratuais.
A resiliência introduz novos trade-offs. Replicação amplia disponibilidade, mas pode duplicar pesos residentes e reduzir eficiência global. Retry automático melhora recuperação de algumas falhas, mas também pode multiplicar carga sobre um sistema degradado. Autoscaling responde a crescimento de demanda, embora carregamento de modelos e inicialização de workers apresentem custos temporais relevantes.
Decisões dessa natureza precisam ser documentadas e avaliadas continuamente. Architecture Decision Records, experimentos canary e critérios de rollback permitem conectar hipóteses técnicas a resultados observáveis. A responsabilidade de Staff e Principal AI Engineers consiste em transformar escolhas de infraestrutura em decisões justificáveis de negócio. Baixa latência representa valor somente quando acompanhada de confiabilidade, qualidade, previsibilidade de custos e capacidade sustentável de evolução.
7.1. GPU economics: custo por milhão de tokens, custo por requisição útil e throughput sob restrições de SLO
O custo de LLM serving precisa ser calculado a partir da capacidade efetivamente entregue, não apenas do preço horário das GPUs. Uma aproximação inicial para custo por milhão de tokens consiste em dividir a despesa computacional total pelo volume produzido, multiplicando o resultado por um milhão. Entretanto, esse indicador pode favorecer configurações que processam muitos tokens enquanto violam requisitos de latência.
Uma métrica mais robusta utiliza tokens ou requisições concluídos dentro dos SLOs. Nesse caso, o denominador representa goodput, permitindo incorporar o efeito econômico de respostas atrasadas, rejeitadas ou interrompidas. O cálculo deve considerar também diferenças entre input e output tokens, pois prefill e decode possuem custos computacionais distintos. Um milhão de tokens de entrada não representa necessariamente o mesmo consumo que um milhão de tokens gerados.
O custo total inclui GPU rental ou amortização, memória, rede, energia e capacidade reservada. Em arquiteturas disaggregated, GPUs dedicadas a prefill podem permanecer ociosas enquanto decode enfrenta saturação. Em configurações excessivamente paralelizadas, comunicação pode reduzir tokens produzidos por GPU. Essas ineficiências precisam aparecer explicitamente na modelagem econômica.
A análise deve calcular custo marginal sob diferentes níveis de utilização e distribuições de contexto. Também precisa considerar o custo de manter headroom para bursts e recuperação de falhas. Comparar modelos, quantization e frameworks exclusivamente por tokens por segundo ignora essas dimensões. Uma arquitetura economicamente eficiente maximiza respostas corretas e pontuais por unidade monetária, respeitando requisitos de disponibilidade e capacidade de crescimento.
7.2. Capacity planning e autoscaling: modelagem de demanda, dimensionamento de GPU pools e utilização versus headroom
Capacity planning para LLM inference exige relacionar características de demanda às restrições físicas da infraestrutura. Requisições por segundo representam apenas uma dimensão. Input length, output length, concorrência, cache hit ratio e distribuição temporal alteram significativamente a capacidade sustentada. Dois workloads com a mesma taxa de chegada podem exigir quantidades diferentes de GPUs devido à composição das fases de prefill e decode.
A Lei de Little estabelece uma relação entre número médio de requisições no sistema, taxa efetiva de conclusão e tempo médio de permanência em condições estáveis. Essa relação ajuda a interpretar concorrência e latência, mas não determina isoladamente a capacidade de atendimento. Próximo da saturação, pequenas elevações na demanda podem produzir crescimento acentuado das filas. Modelos de dimensionamento precisam incorporar essa não linearidade.
Autoscaling apresenta desafios específicos porque novos inference workers podem exigir carregamento de pesos, inicialização de kernels e preparação de estruturas de memória. O tempo necessário para disponibilizar capacidade pode ser superior à duração de determinados picos. Consequentemente, estratégias exclusivamente reativas podem chegar tarde. Forecasting de demanda, capacidade previamente aquecida e políticas de scale-out antecipado podem oferecer maior estabilidade.
A decisão também precisa equilibrar utilização e headroom. Reservar capacidade reduz risco de violações de SLO, mas aumenta custo fixo. Em arquiteturas com prefill e decode separados, cada pool demanda projeções próprias e mecanismos de redistribuição. Uma avaliação adequada utiliza traces históricos, simulações de burst e testes de saturação. O resultado esperado é uma política capaz de controlar custo sem transformar variações normais de demanda em degradações sistêmicas.
7.3. Backpressure, overload protection, cancellation e retry semantics: confiabilidade diante de picos e falhas parciais
Sistemas de inferência precisam estabelecer comportamento explícito quando a demanda ultrapassa a capacidade disponível. Sem backpressure, novas requisições continuam entrando enquanto filas crescem e recursos são consumidos por trabalhos que provavelmente não terminarão dentro dos deadlines. Esse cenário pode provocar timeouts, retries simultâneos e amplificação da sobrecarga. A proteção começa antes da saturação completa dos aceleradores.
Admission control deve considerar capacidade efetiva, pressão de memória e compromissos de latência. Quando necessário, a plataforma precisa rejeitar novas requisições com respostas apropriadas, incluindo informações de retry quando compatíveis com o protocolo. Rate limiting, bounded queues e circuit breakers ajudam a impedir propagação de falhas. Entretanto, políticas estáticas podem ser insuficientes para workloads com custos computacionais altamente variáveis.
Cancellation representa outra dimensão frequentemente negligenciada. Quando um cliente encerra uma conexão ou abandona uma operação, o inference engine precisa interromper a geração quando apropriado e liberar recursos associados. Continuar produzindo tokens sem consumidor desperdiça GPU cycles e KV Cache. A propagação de cancelamento entre gateway, scheduler e workers precisa ser explícita e observável.
Retry semantics são particularmente delicadas em streaming. Depois que parte da resposta foi entregue, uma repetição automática pode produzir conteúdo duplicado ou semanticamente diferente. A plataforma deve distinguir falhas anteriores ao início da geração de falhas após emissão parcial. Idempotency keys, deadlines e limites de tentativas reduzem comportamentos inesperados. Reliability engineering exige testar interrupções, perda de workers e degradação de rede, verificando recuperação de recursos e proteção contra cascatas.
7.4. Architecture Decision Records e rollout controlado: como justificar e validar mudanças no inference stack
Mudanças em um inference stack frequentemente afetam simultaneamente desempenho, qualidade, segurança e custo. Atualizar o serving engine, alterar quantization ou modificar scheduling pode introduzir regressões difíceis de identificar sem documentação prévia. Architecture Decision Records oferecem um mecanismo para registrar contexto, alternativas, hipóteses, critérios de seleção e consequências esperadas. O objetivo é preservar racionalidade técnica e facilitar revisões futuras.
Um ADR relevante deve explicitar workload, restrições de hardware, SLOs, requisitos de qualidade e métricas econômicas. Também precisa documentar alternativas rejeitadas e condições que invalidariam a decisão. Por exemplo, a adoção de disaggregated serving pode depender de determinada distribuição de prompts e disponibilidade de interconnect eficiente. Se essas condições mudarem, a escolha precisa ser reavaliada.
Rollout controlado permite verificar hipóteses progressivamente. Uma estratégia pode começar com shadow traffic para medir desempenho sem impactar respostas, seguida de canary deployments com pequena parcela de tráfego real. Entretanto, shadow traffic exige isolamento de capacidade e atenção a efeitos colaterais. Comparações devem controlar diferenças de workload e evitar que versões concorrentes contaminem os resultados por compartilhamento indevido de recursos.
Critérios de rollback precisam existir antes da implantação. Regressões de TTFT, ITL, error rate, qualidade ou custo podem justificar reversão automática ou supervisionada. A decisão deve considerar intervalos de confiança, duração da observação e criticidade das métricas. O princípio fundamental é tratar cada alteração arquitetural como uma hipótese testável. A excelência em AI Engineering resulta da capacidade de transformar mudanças complexas em experimentos reproduzíveis, decisões auditáveis e melhorias sustentáveis de produção.
Security Architecture para AI Agents: como projetar autonomia com limites de confiança…
SRE para AI Systems: Arquitetura de Confiabilidade e Garantias de Produção em Sistemas…
Observability para AI Agents em Produção: Como Observar Comportamento, Decisões e Trajetórias,…