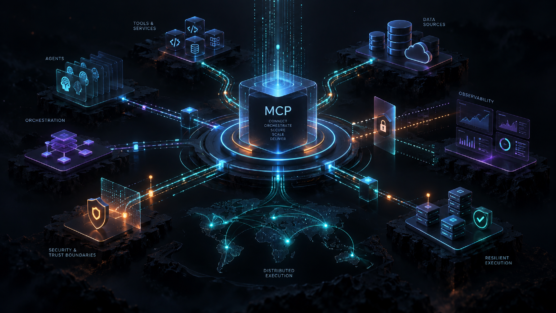
A segurança de AI Agents não pode ser tratada como uma extensão dos filtros de conteúdo utilizados em aplicações convencionais de Large Language Models. Quando um sistema passa a selecionar ferramentas, consultar informações externas, delegar atividades e modificar estados de negócio, a questão central deixa de ser apenas a qualidade da resposta. Passa a ser quais efeitos um componente probabilístico consegue produzir, sob qual identidade, com quais permissões e mediante quais evidências de autorização.
Uma arquitetura madura parte de uma separação inegociável: o modelo pode propor intenções e planos, mas componentes determinísticos precisam decidir quais capacidades podem ser exercidas. Essa distinção desloca o foco de prompt engineering para trust boundaries, policy enforcement, isolamento de execução e governança de privilégios. Prompt injection continua relevante, porém seu impacto real depende da autoridade que o runtime entrega ao agente e das oportunidades de atravessar fronteiras de confiança.
Para profissionais Staff e Principal, o desafio consiste em compor segurança, disponibilidade, custo e autonomia em uma única estratégia de engenharia. Um sistema excessivamente restritivo inviabiliza automações legítimas; um sistema permissivo converte documentos, ferramentas e mensagens entre agentes em canais indiretos de comando. A solução exige threat modeling contextual, contratos de ferramentas, avaliação adversarial contínua, trilhas auditáveis e decisões explícitas sobre risco residual.
Este artigo desenvolve uma reference architecture para agentes de produção, examinando mecanismos de autorização, identidade, memória, tool supply chain, avaliação, incident response e economics. A tese é que autonomia confiável não nasce da obediência do LLM. Ela emerge de limites verificáveis, controles independentes e evidências operacionais de que uma decisão incorreta não se transforma automaticamente em uma ação irreversível.
Fale comigo no LinkedIn: https://www.linkedin.com/in/celso-sousa/
1. O problema arquitetural da autonomia: quando decisões probabilísticas ganham privilégios operacionais
A introdução de autonomia altera a natureza do risco porque substitui uma interação predominantemente informacional por um ciclo de percepção, planejamento, atuação e observação. Um chatbot que resume uma fatura pode produzir uma conclusão incorreta. Um agente autorizado a editar fornecedores, executar pagamentos ou enviar mensagens pode transformar a mesma interpretação incorreta em uma alteração persistente, difícil de detectar e potencialmente custosa.
Modelar essa transição exige distinguir quatro dimensões: capacidade disponível, autoridade efetivamente concedida, contexto consumido e impacto potencial de cada ação. O conjunto de ferramentas informa o que é tecnicamente possível; a autorização define o que deveria ser permitido; o contexto influencia a escolha probabilística; e as dependências downstream determinam o alcance dos efeitos. Segurança aparece quando essas dimensões deixam de ser confundidas.
Um erro recorrente em AI Engineering consiste em tratar a intenção expressa no prompt como identidade autorizadora. Instruções de sistema, solicitações do usuário e conteúdo recuperado possuem diferentes níveis de confiança, mas todos terminam próximos na janela de contexto. A hierarquia textual ajuda o comportamento do modelo, sem substituir decisões verificáveis de acesso a recursos. Uma instrução maliciosa pode ser rejeitada estatisticamente e ainda assim explorar uma única execução permissiva.
Portanto, o objeto primário do threat modeling não é o prompt isolado, mas a trajetória completa entre entrada não confiável e side effect. O arquiteto deve responder quais dados podem influenciar uma decisão, quais ferramentas aceitam essa decisão, qual principal será utilizado e como a operação será interrompida ou revertida. Esse enquadramento permite defender sistemas complexos sem depender da premissa irrealista de infalibilidade semântica.
1.1. De LLM Applications a sistemas agênticos: a mudança fundamental no modelo de ameaças
Nas aplicações tradicionais de LLM, a superfície de ataque costuma concentrar-se na manipulação das entradas, exposição de dados e contaminação das saídas. Em arquiteturas agênticas, o modelo participa de um loop operacional capaz de encadear decisões. Cada tool call pode alterar o ambiente observado pela próxima etapa, criando dependências entre ações, estados intermediários e oportunidades de escalonamento de privilégios.
Considere um agente de procurement que consulta contratos, compara propostas e prepara aprovações. Uma página de fornecedor comprometida pode sugerir uma alteração de conta bancária como se fosse uma atualização administrativa. Caso o agente disponha de escrita no cadastro e acesso ao fluxo de pagamento, o ataque atravessa o limite entre evidência comercial e autoridade operacional. O problema não reside apenas na frase maliciosa, mas na composição das permissões.
O threat model deve representar o agente como um sistema composto por modelo, orquestrador, ferramentas, provedores de identidade, armazenamento, fontes externas e operadores humanos. Para cada componente, identifique trust level, credenciais, permissões, estado manipulável e destinos de dados. Diferencie execução somente de leitura, mutações reversíveis e operações com consequências financeiras, legais ou físicas. Essas classes requerem controles distintos.
Também é necessário examinar comportamentos emergentes de loops longos: replanejamento após falhas, recuperação automática, delegação para subagentes e persistência de memória. Um passo aparentemente inofensivo pode ampliar o alcance de um ataque em etapas seguintes. Por isso, a unidade de segurança não deve ser a resposta individual, mas a cadeia de ações autorizadas. O critério de maturidade é conseguir explicar, antes da execução, quais estados um agente pode alcançar e quais transições continuarão proibidas.
1.2. Attack Graphs e Trust Boundaries: mapeando superfícies de ataque em workflows autônomos
Diagramas de arquitetura que mostram apenas caixas de agentes e setas de ferramentas escondem o principal: onde informação não confiável adquire capacidade de produzir ações. Um attack graph útil representa nós como ativos e estados privilegiados, e arestas como oportunidades concretas de transição. Entre elas estão ler um documento externo, interpretar uma instrução, selecionar uma ferramenta, obter um token e realizar uma mutação.
Cada aresta deve registrar pré-condições, principal de execução, política aplicada, evidência gerada e impacto máximo. No exemplo de um agente de atendimento, uma mensagem recebida por email poderia influenciar uma consulta ao CRM, que por sua vez produz uma atualização cadastral e dispara uma notificação. O grafo precisa mostrar que o email não é uma fonte autorizadora, mesmo quando seus dados são relevantes para resolver a solicitação.
Uma prática avançada consiste em anotar trust boundaries por origem e finalidade, não apenas por localização de rede. Dados obtidos de um repositório corporativo podem permanecer não confiáveis como instruções, enquanto uma política emitida por serviço autenticado pode ser considerada autoritativa apenas no seu escopo. A distinção impede que um conteúdo legítimo para recuperação documental seja promovido silenciosamente a comando operacional.
Attack graphs também permitem identificar pontos de corte. Se todos os caminhos até uma transferência financeira atravessam um policy enforcement point independente, aquela fronteira concentra valor defensivo. Se existe uma rota alternativa por uma ferramenta administrativa genérica, o isolamento anunciado é ilusório. Priorize a análise de caminhos com maior blast radius, combinações de permissões e menor detectabilidade. O resultado esperado não é um inventário estático de ameaças, mas um modelo de alcance operacional que evolui com novas ferramentas, integrações e mudanças de workflow.
1.3. Prompt Injection, Goal Hijacking e Memory Poisoning como vetores de comprometimento sistêmico
Prompt injection não deve ser reduzido ao clichê de pedir ao modelo que ignore instruções anteriores. Em agentes de produção, o atacante explora o fato de que conteúdo necessário para executar uma tarefa também pode carregar linguagem imperativa. Páginas recuperadas, respostas de ferramentas, issues, emails e arquivos podem tentar redirecionar o objetivo, produzir chamadas indevidas ou adulterar a interpretação de políticas.
Goal hijacking ocorre quando a trajetória operacional passa a otimizar uma finalidade introduzida pelo adversário. Memory poisoning amplia a janela temporal desse comprometimento: uma preferência, resumo ou fato adulterado pode persistir entre sessões e contaminar decisões futuras. Em sistemas multiagentes, a propagação pode acontecer quando um agente resume uma fonte maliciosa e outro interpreta esse resumo como evidência validada, apagando a proveniência original.
A defesa precisa combinar controles em camadas. Separe instruções de dados em schemas distintos, preserve source attribution, classifique fontes por confiabilidade e aplique autorização depois que a intenção de ferramenta estiver completamente materializada. Sanitização textual e classificadores de injeção ajudam a reduzir exposição, porém não comprovam que uma ação é legítima. Uma chamada para alterar dados bancários deve falhar por falta de autorização contextual, independentemente da confiança atribuída ao texto que a sugeriu.
Na avaliação, teste sequências adaptativas nas quais o invasor não tenta vencer uma única classificação, mas induzir pequenos desvios acumulados. Meça também contaminação de memória, persistência após reinício e transbordamento entre usuários. O princípio essencial é impedir que material de baixa confiança altere o conjunto de objetivos, permissões ou políticas efetivamente aplicadas. Prompts são parte do sistema de orientação; fronteiras de segurança precisam existir fora deles.
1.4. Blast Radius, Transitive Trust e Cascading Failures: como falhas locais comprometem sistemas distribuídos
O blast radius de um agente corresponde ao conjunto de recursos, usuários e processos afetáveis por uma execução comprometida. Essa extensão raramente coincide com as permissões diretas do modelo. Uma ferramenta pode disparar webhooks, publicar eventos, atualizar índices, iniciar jobs e acionar agentes especializados. Cada dependência acrescenta novas transições e pode transformar uma falha local em incidente sistêmico.
Transitive trust surge quando um componente aceita conclusões ou solicitações de outro sem revalidar a autoridade original. Um agente de análise pode enviar uma recomendação ao agente de operações; este, ao assumir que a recomendação já foi aprovada, executa uma mudança administrativa. A cadeia aparenta conter múltiplas verificações, mas nenhuma delas comprova autorização do usuário ou conformidade com a política empresarial no momento da mutação.
A arquitetura deve limitar propagação por identidade independente, escopos estreitos, quotas de ação, segregação de ambientes e contratos de delegação verificáveis. Mensagens entre agentes precisam carregar identificadores de origem, correlação, finalidade, classificação de dados e referência ao contexto de autorização. Esses atributos não podem depender de uma declaração textual do próprio modelo. Quando uma chamada inicia trabalho assíncrono, a política precisa sobreviver à fila e ser novamente validada no consumidor.
Cascading failures também podem ser econômicas. Um loop de retries sem limite pode consumir tokens, saturar ferramentas externas e gerar custos de infraestrutura antes de qualquer ação maliciosa explícita. Defina budgets por execução, limites por ferramenta, circuit breakers e critérios de interrupção por risco. A métrica relevante deixa de ser apenas a probabilidade de falha de um componente e passa a incluir o dano condicionado à falha, o tempo de detecção e a capacidade real de contenção.
2. Reference Architecture: separando inteligência, autorização e execução
Uma reference architecture segura precisa preservar a capacidade do LLM de interpretar objetivos complexos sem transformá-lo em autoridade final sobre recursos corporativos. O desenho recomendado separa a camada cognitiva, responsável por planejar e propor ações, da camada de autorização, responsável por determinar o que é permitido, e da camada de execução, responsável por aplicar limites técnicos e registrar efeitos. Essa separação deve existir na topologia real, não apenas em documentação.
O fluxo começa com um pedido autenticado que produz um execution context imutável: identidade do solicitante, finalidade, tenant, restrições de dados, prazo e orçamento de risco. O orquestrador expõe apenas capabilities compatíveis com esse contexto. Quando o modelo propõe uma ferramenta, seus argumentos passam por validação de schema, classificação de risco e decisão de política. Uma aprovação, quando necessária, vincula-se à operação exata, não a uma autorização genérica para continuar.
A execução ocorre em um gateway que obtém credenciais de curta duração, controla destinos e registra resultados verificáveis. O modelo recebe apenas a representação necessária do retorno, evitando exposição de tokens, segredos e metadados internos. Para operações com efeitos externos, registre identificadores de idempotência e evidências de conclusão. Para workflows longos, preserve estado de aprovação e checkpoints sem transformar memória do agente em banco autoritativo de permissões.
O valor desse arranjo é reduzir acoplamento entre modelos, frameworks de orquestração e fornecedores de ferramentas. Alterar o modelo não deveria modificar a política de autorização; adicionar uma ferramenta não deveria herdar privilégios por acidente. Segurança arquitetural madura significa que componentes podem evoluir independentemente sem comprometer invariantes como segregação de funções, rastreabilidade e limitação de blast radius.
2.1. Control Plane vs. Data Plane: por que agentes não devem controlar suas próprias políticas de segurança
A distinção entre control plane e data plane torna explícito quem define as regras e quem executa trabalho. O control plane administra identidades, catálogos de capacidades, versões de políticas, configurações de risco e critérios de aprovação. O data plane processa requisições, recupera contexto, seleciona ferramentas e realiza operações. O componente probabilístico pertence ao caminho de execução e não deve possuir mecanismos para alterar suas próprias condições de autorização.
Essa separação não precisa implicar dois clusters ou produtos distintos. Trata-se de estabelecer autoridade e isolamento lógico com garantias verificáveis. Políticas podem ser distribuídas em caches locais para reduzir latência, desde que possuam versão, validade, mecanismo de revogação e comportamento definido quando o serviço de controle falha. Para mutações críticas, depender de uma cópia indefinidamente desatualizada representa uma escolha de risco inaceitável.
A alteração de um prompt, de um catálogo MCP ou de uma skill também merece classificação no control plane quando modifica capacidades disponíveis. Um agente autorizado a editar seu próprio manifesto de ferramentas pode reconfigurar indiretamente a superfície de ataque. Mantenha esses artefatos sob versionamento, revisão independente, assinatura quando apropriado e promoção por ambientes. Mudanças devem produzir diffs interpretáveis e ser submetidas a testes de segurança antes de chegar ao runtime.
Uma decisão arquitetural relevante envolve centralizar ou distribuir enforcement. Centralização favorece consistência e auditoria, mas acrescenta dependência operacional. Enforcement distribuído reduz hops e suporta isolamento regional, porém exige gestão rigorosa de versões. Em ambos os casos, a invariante permanece: a sugestão do LLM nunca concede privilégios a si mesma. Apenas uma autoridade externa, vinculada a identidade e contexto verificáveis, pode permitir a transição privilegiada.
2.2. Policy Decision Points e Policy Enforcement Points: autorização determinística fora do LLM
O Policy Decision Point, ou PDP, calcula se uma ação proposta pode ocorrer. O Policy Enforcement Point, ou PEP, impede a operação caso essa decisão não autorize sua execução. Em AI Agents, o PEP deve posicionar-se no último caminho obrigatório antes do side effect. Validar uma chamada apenas no orquestrador é insuficiente se outra integração consegue acessar diretamente a mesma API com credenciais amplas.
Uma decisão robusta considera subject, action, resource e environment, além de atributos como finalidade, classificação de dados, horário, aprovação, orçamento e risco. O modelo pode solicitar create_invoice, porém o PDP avalia se aquele usuário pode criar uma fatura para aquele fornecedor, naquele valor e naquela unidade de negócio. O resultado precisa ser vinculante para os argumentos avaliados. Alterar o destinatário após obter aprovação invalida a decisão.
Policy-as-Code permite expressar essas regras em sistemas versionáveis, como motores ABAC ou ReBAC, sem acoplar autorização à linguagem natural. O PEP deve tratar ausência de política, inconsistência de atributos e falha de conectividade segundo estratégias explícitas. Para transferências e exclusões, normalmente prevalece fail closed; para operações somente de leitura e baixo risco, podem existir modos degradados previamente aprovados. A exceção deve ser desenhada, não improvisada.
Há também um problema de tempo: uma autorização válida no planejamento pode tornar-se inválida na execução. Revalide operações sensíveis imediatamente antes do commit, utilizando políticas e atributos atuais. Registre policy version, decision ID e justificativas estruturadas, sem expor segredos. Isso torna possível explicar por que uma chamada foi permitida e reproduzir a decisão durante auditorias. Segurança verificável depende tanto do bloqueio correto quanto da capacidade de demonstrar como ele ocorreu.
2.3. Zero Trust, Least Privilege e Capability-Based Security aplicados à execução agêntica
Zero Trust, em sistemas agênticos, significa não presumir confiabilidade de uma ação porque ela foi proposta por um agente interno, por um modelo reputado ou por uma ferramenta instalada. Cada operação deve ser autenticada, autorizada e limitada pelo contexto. Least privilege reduz o conjunto de ações disponíveis ao mínimo necessário; capability-based security torna esse princípio operacional por meio de permissões explícitas associadas a recursos e efeitos específicos.
Em vez de entregar ao agente uma credencial de administrador do CRM, o orquestrador pode expor uma capability para atualizar um campo determinado de um registro, por tempo limitado e com restrição de escopo. Uma capability pode representar somente leitura de relatórios financeiros, criação de rascunhos ou envio condicionado à aprovação. Essa granularidade reduz a distância entre intenção de negócio e autoridade concedida, diminuindo oportunidades de uso indevido.
A implementação exige cuidado para não transformar nomes de ferramentas em políticas. Uma função chamada safe_update ainda pode possuir parâmetros capazes de alterar atributos críticos. Avalie operações reais, argumentos, efeitos transitivos e permissões concedidas ao backend. Também diferencie capabilities estáticas, definidas no deployment, e dinâmicas, emitidas para um workflow após autenticação e avaliação de risco. Em ambos os casos, os tokens precisam de audience binding e proteção contra reutilização.
O trade-off aparece na complexidade administrativa. Capacidades muito genéricas aumentam blast radius; capacidades excessivamente específicas multiplicam configurações e dificultam evolução. Uma solução equilibrada combina famílias de operações padronizadas, filtros de recurso e restrições contextuais. O objetivo não é proibir autonomia, mas garantir que ela permaneça dentro de um espaço de estados previamente autorizado. O agente escolhe caminhos nesse espaço; a arquitetura impede que ele o expanda unilateralmente.
2.4. Sandboxing, Network Egress Control e Execution Isolation: contenção de ações com efeitos colaterais
Um agente com acesso a execução de código ou navegação web opera sobre uma superfície muito maior que um agente limitado a consultas tipadas. Sandboxing deve restringir sistema de arquivos, processos, interfaces de rede, recursos computacionais e persistência. Contêineres, microVMs e ambientes efêmeros oferecem diferentes níveis de isolamento, mas nenhum mecanismo isolado substitui configuração correta de permissões, kernel, volumes e destinos de saída.
Network egress control é particularmente importante porque a exfiltração pode ocorrer por ferramentas aparentemente legítimas. Um script pode enviar dados para um endpoint externo; uma integração de email pode encaminhar anexos; uma URL pode incorporar informações sensíveis em parâmetros. A política deve autorizar destinos por finalidade e impedir conexões arbitrárias, inclusive acessos a endpoints de metadata e serviços internos não destinados à execução. DNS e proxies também fazem parte do perímetro.
Para tarefas com side effects, isole a fase de preparação da fase de aplicação. Um agente pode gerar um plano de migração, realizar verificações sintáticas e simular alterações em um ambiente descartável antes de solicitar autorização de deploy. O artefato aprovado deve ser exatamente o executado, utilizando hash, versão e parâmetros congelados. Caso contrário, surge um intervalo de troca entre revisão e commit, conhecido como problema de time of check versus time of use.
Há custos mensuráveis: inicialização de sandboxes, duplicação de ambientes, armazenamento temporário e observabilidade aumentam latência e consumo. Por isso, defina tiers de isolamento conforme risco, sem abrir exceções silenciosas para ferramentas críticas. O objetivo arquitetural é limitar o pior efeito possível de uma execução comprometida, não apenas aumentar a probabilidade de o modelo se comportar corretamente durante uma execução normal.
3. Identity, Delegation e Tool Security: controlando a cadeia de confiança
A identidade em sistemas agênticos é mais complexa que a autenticação de uma aplicação convencional. Uma única tarefa pode atravessar usuário, frontend, orquestrador, agente especializado, servidor MCP e API corporativa. Cada salto levanta uma pergunta diferente: quem iniciou a operação, quem a executa, em nome de quem atua e quem possui autoridade para aprovar o efeito final. Quando essas identidades são fundidas em uma conta de serviço genérica, desaparece a possibilidade de aplicar least privilege de maneira confiável.
Uma arquitetura segura distingue actor identity, workload identity e delegated authority. O usuário autentica a intenção inicial; workloads provam a identidade técnica dos componentes; a delegação estabelece quais permissões podem ser exercidas em nome do solicitante. O histórico da conversa não constitui prova de nenhuma dessas propriedades. Dados de autenticação devem ser emitidos e validados por mecanismos independentes, com audience, prazo de validade e vínculo explícito ao recurso.
Ferramentas adicionam outro risco: seus nomes, descrições e schemas influenciam a escolha feita pelo modelo. Uma integração comprometida pode manipular parâmetros, devolver conteúdo adversarial ou apresentar capacidades mais amplas que as anunciadas. Por isso, a cadeia de confiança inclui distribuição de software, versionamento de skills, integridade dos manifests, isolamento de servidores e verificação das respostas. A confiança nunca deve ser concedida apenas porque uma ferramenta foi descoberta automaticamente.
Para Staff Engineers, o foco precisa estar nos contratos entre fronteiras. Cada delegação deve restringir escopo, duração e contexto; cada ferramenta deve oferecer semântica auditável; cada mudança de capacidade deve passar por revisão. Assim, uma arquitetura com múltiplos agentes permanece governável mesmo quando seus componentes são desenvolvidos por equipes e fornecedores diferentes.
3.1. Agent Identity, Workload Identity e Delegated Authorization: quem realmente responde por cada ação?
A expressão identidade do agente costuma esconder três conceitos distintos. Agent identity identifica logicamente o componente e sua versão; workload identity autentica o processo que está realizando uma chamada; delegated authorization delimita o direito de agir em nome de uma pessoa ou sistema. Misturar essas camadas permite que um agente apresente sua própria descrição como autorização suficiente, cenário incompatível com auditoria e controles corporativos.
Em um fluxo de atualização financeira, a trilha deveria preservar user principal, agent instance, workload attestation, policy decision e target resource. A autorização não deve acompanhar apenas uma string como approved_by_manager, já que esse valor pode ser produzido ou alterado no próprio contexto do modelo. Use referências assinadas, claims verificáveis e um mecanismo de aprovação externo, associado à ação e ao conjunto exato de argumentos.
Identidades de workload podem ser implementadas com mecanismos de autenticação máquina a máquina, credenciais emitidas pela infraestrutura e certificados de curta duração. A escolha concreta depende do ambiente, porém o objetivo é impedir que um processo comprometido represente outro sem comprovação criptográfica. Para operações delegadas, tokens devem indicar sujeito, público pretendido, escopos e condições de uso. Uma cadeia de delegação não pode criar poderes inexistentes no solicitante original.
Também é indispensável definir accountability quando múltiplos agentes colaboram. O agente planejador responde pela proposta, mas o executor deve revalidar sua própria autorização. O serviço que aplica a mutação registra o ator técnico e o solicitante originário. Esse encadeamento evita o problema de atribuição difusa, no qual ninguém consegue explicar a origem de uma alteração. A autonomia pode ser distribuída; a responsabilidade por cada transição precisa continuar individualizável e demonstrável.
3.2. Scoped Credentials, Short-Lived Tokens e Just-in-Time Privileges: eliminando permissões persistentes
Credenciais permanentes são especialmente perigosas em AI Agents porque uma única sequência maliciosa pode induzir várias chamadas consecutivas. Quando um processo recebe acesso amplo a armazenamento, email e sistemas administrativos, qualquer falha de decisão pode reutilizar esses privilégios fora da finalidade original. A mitigação estrutural consiste em emitir credenciais sob demanda, limitadas por tempo, recurso, audiência e operação.
Just-in-Time Privileges reduzem o intervalo durante o qual uma capacidade existe. O orquestrador solicita autorização para uma ação concreta e o gateway obtém o token necessário apenas no instante da execução. O modelo nunca visualiza esse segredo. Após a chamada, a credencial expira ou é revogada conforme o mecanismo disponível. Para tarefas longas, renove a autorização no ponto de uso, sem copiar tokens para memória conversacional ou checkpoints.
O desenho deve considerar riscos de token passthrough. Encaminhar a um serviço intermediário uma credencial destinada a outra API enfraquece validação de audience e amplia a possibilidade de uso indevido. Prefira token exchange ou mecanismos equivalentes de delegação com escopos efetivamente reduzidos. Registre também quem solicitou cada credencial, a política aplicada e sua correlação com a execução, sem armazenar valores sensíveis em logs.
Esse modelo introduz latência, dependência de serviços de identidade e maior complexidade operacional. Caches podem ser úteis, mas exigem TTL curto, isolamento por principal e invalidação coerente. Em tarefas críticas, a redução do blast radius normalmente compensa o custo adicional. Uma arquitetura deve ser avaliada não pelo número de tokens emitidos, mas pelo tempo durante o qual um comprometimento consegue produzir ações não autorizadas e pela facilidade de revogar esse poder.
3.3. MCP, A2A e Tool Supply Chain: Tool Poisoning, Confused Deputy e comprometimento de dependências
Protocolos de integração como Model Context Protocol, ou MCP, e Agent2Agent, ou A2A, padronizam comunicação, mas não tornam automaticamente confiáveis os servidores ou agentes conectados. Uma descrição de ferramenta pode influenciar seleção e argumentos; uma resposta pode incluir instruções adversariais; um componente intermediário pode tentar utilizar permissões do chamador para acessar recursos de terceiros. A padronização do transporte não elimina a necessidade de estabelecer fronteiras de confiança.
Tool poisoning pode ocorrer na distribuição de um servidor, na alteração de metadados ou no conteúdo retornado durante a execução. Confused deputy aparece quando um serviço com autoridade legítima é induzido a utilizá-la para uma finalidade não autorizada. Uma ferramenta de busca documental, por exemplo, não deveria conseguir converter acesso de leitura a contratos em autorização para compartilhar os contratos com um destinatário externo, mesmo quando a solicitação parece vir de outro agente.
Defina uma cadeia de suprimentos com origem verificável, versões fixadas, inventário de dependências, revisão de permissões e testes de regressão. Catálogos de ferramentas devem tratar annotations e descrições como metadados não autoritativos. Para integrações HTTP, valide a audiência dos tokens e rejeite encaminhamento indevido de credenciais. Para servidores locais, limite privilégios do processo, acesso a arquivos e conexões de rede. A segurança depende da configuração concreta do host e de cada servidor.
Na comunicação entre agentes, estabeleça autenticação mútua, envelopes de mensagem tipados e autorização para cada operação downstream. Não presuma que um resultado emitido por um agente confiável tenha origem em fontes igualmente confiáveis. A proveniência precisa sobreviver à orquestração. O controle decisivo é garantir que uma integração possa transmitir dados úteis sem adquirir autoridade para ampliar políticas, redirecionar objetivos ou assumir a identidade de quem a invocou.
3.4. Context Provenance, Memory Integrity e Inter-Agent Trust: prevenindo a propagação de instruções maliciosas
A memória de um agente pode misturar fatos recuperados, preferências do usuário, decisões anteriores, resumos automáticos e metadados de execução. Tratar tudo isso como contexto homogêneo cria um problema de proveniência. Um resumo produzido a partir de um documento adulterado pode parecer mais confiável que a fonte original, especialmente quando o pipeline elimina referências, timestamps e classificação de dados para economizar tokens.
Uma arquitetura robusta precisa associar cada elemento de contexto a origem, momento de coleta, política de retenção, finalidade permitida e nível de confiança. Em sistemas com Retrieval-Augmented Generation, ou RAG, metadados devem acompanhar chunks, reranking e sínteses. A assinatura de um artefato pode comprovar integridade desde determinada origem, mas não garante veracidade do conteúdo nem sua legitimidade como instrução. Essas propriedades devem permanecer separadas no contrato de dados.
Memórias persistentes exigem controles adicionais. Escritas devem passar por validação de schema, autorização e classificação, com quarentena para informações suspeitas. Para atributos sensíveis, considere append-only records, versionamento e revisão antes de substituir fatos utilizados por workflows críticos. Expiração e revalidação reduzem o risco de decisões baseadas em condições comerciais desatualizadas. Uma preferência armazenada não deve alterar políticas de execução nem conceder novos escopos de acesso.
No compartilhamento entre agentes, transmita claims acompanhadas de referências e escopo, em vez de resumos que apagam a cadeia de custódia. O receptor verifica se a fonte é apropriada à decisão pretendida. Esse custo de metadados pode aumentar armazenamento e tokens, mas permite detectar contaminação e reproduzir incidentes. A pergunta arquitetural correta não é se um agente confia em outro. É quais afirmações específicas ele pode aceitar, para qual finalidade e sob quais evidências independentes.
4. Secure Agent Design System: transformando segurança em contratos arquiteturais reutilizáveis
Um design system para AI Engineering não deveria limitar-se a convenções de prompts, nomenclatura de agentes e templates de ferramentas. Em produção, a maior oportunidade de padronização está nos contratos que tornam segurança uma propriedade composicional. Quando cada equipe implementa sua própria lógica de aprovação, isolamento, retries e observabilidade, o risco cresce com o número de integrações, mesmo que os agentes individuais pareçam corretamente configurados.
A plataforma deve oferecer componentes reutilizáveis: tool gateway, identity adapter, policy client, execution sandbox, approval service, secrets broker e trace collector. Cada componente precisa publicar invariantes verificáveis, versões compatíveis e modos de falha conhecidos. Por exemplo, uma ferramenta de escrita só é admitida se declarar classificação de side effects, requisitos de autorização, schema de argumentos e mecanismo de idempotência. Esse contrato precisa ser validado no onboarding e novamente em mudanças relevantes.
O objetivo é criar golden paths para casos recorrentes. Uma consulta de baixa sensibilidade segue um caminho rápido e observável. Uma operação financeira combina pré-validação, aprovação vinculada ao payload, execução isolada e verificação pós-commit. Uma integração experimental pode acessar ambientes sintéticos sem possuir conectividade de produção. Escape hatches são possíveis, mas precisam de responsáveis, justificativa, prazo e controles compensatórios, para não converter exceções em arquitetura dominante.
A maturidade do design system depende de adoption metrics e security outcomes. Meça percentual de ferramentas registradas com contratos completos, cobertura de policy enforcement, tempo de integração, exceções vigentes e incidentes evitados por controles compartilhados. Uma boa plataforma reduz esforço cognitivo das equipes e torna o caminho seguro o mais fácil. Padronização é valiosa quando preserva autonomia de desenvolvimento sem permitir que cada projeto redefina suas próprias fronteiras de confiança.
4.1. Security-by-Design Patterns: Tool Gateways, Capability Registries e Policy-as-Code
Tool gateways funcionam como pontos de mediação entre a intenção produzida pelo modelo e APIs com efeitos reais. Eles centralizam validação, autenticação, rate limiting, observabilidade e decisões de autorização. Entretanto, um gateway só é efetivo quando não pode ser contornado por caminhos alternativos. Credenciais diretas distribuídas aos agentes, integrações paralelas e acessos administrativos compartilhados anulam parte importante do controle centralizado.
Capability registries complementam o gateway ao descrever, de forma tipada, o que cada operação faz, quais recursos modifica, qual classificação de dados consome e quais condições exige. Registre também propriedades como reversibilidade, idempotência, custo estimado e owner técnico. O catálogo deve fornecer informações para planejamento e execução, mas somente o motor de políticas determina permissões efetivas. Metadados declarados pelo fornecedor não podem substituir uma avaliação independente.
Policy-as-Code permite tratar mudanças de autorização com disciplina de software. Regras devem ter testes unitários, cenários de conflito, fixtures de identidade e verificação de regressões. Uma alteração que amplia acesso precisa gerar um diff inteligível para revisão. Em arquiteturas complexas, a decisão pode combinar RBAC para funções organizacionais, ABAC para atributos contextuais e relações entre recursos, desde que a semântica final permaneça determinística e auditável.
Evite centralização excessiva do acoplamento. O design system deve expor interfaces estáveis para que equipes substituam frameworks, modelos e provedores sem reescrever controles fundamentais. Defina contratos para allow, deny, obligations e reason codes, incluindo obrigações como aprovação ou mascaramento. O sucesso do padrão não se mede pela existência do gateway, mas pela impossibilidade prática de executar uma ação privilegiada sem atravessar os pontos de enforcement estabelecidos pela plataforma.
4.2. Typed Tool Contracts, Input Validation e Structured Outputs: estabelecendo fronteiras entre dados e instruções
Structured outputs melhoram a previsibilidade de integração, mas não equivalem a autorização. Um JSON válido pode conter uma operação proibida, um destinatário controlado por atacante ou uma consulta excessivamente ampla. Por isso, contratos tipados precisam especificar não apenas estrutura, mas semântica: recursos permitidos, efeitos colaterais, pré-condições, limites de cardinalidade, classificação de dados e regras de validação dependentes do contexto.
Considere uma ferramenta de envio de emails. Seu schema pode exigir recipient, subject e body, porém a validação de segurança precisa avaliar domínios autorizados, presença de dados restritos, finalidade comunicacional e identidade do remetente. Um campo recipient corretamente formatado não prova que a organização permite compartilhar a informação. A mesma distinção vale para SQL gerado por LLM: parsing correto não garante que a query respeite row-level security ou limites de exportação.
Contratos robustos distinguem data plane inputs de policy inputs. O modelo pode sugerir dados e argumentos operacionais, mas não deve preencher livremente campos que definem principal, tenant, escopo aprovado ou decisão de política. Esses atributos são injetados pelo runtime a partir de fontes autenticadas. Adote enums restritivos, limites de tamanho, canonicalização de destinos e validação de referências antes da execução. Para objetos dinâmicos, rejeite propriedades inesperadas quando a flexibilidade criar rotas de evasão.
Também é importante testar schema evolution. Uma nova versão pode introduzir parâmetros opcionais que ampliam a capacidade real da ferramenta. Utilize versionamento semântico, compatibility tests e análise de impacto de permissões. A validação deve ocorrer na fronteira que efetivamente produz o efeito, independentemente do sucesso de parsers anteriores. Em segurança agêntica, um contrato só é completo quando define o que pode acontecer, quem pode solicitar e como o executor verifica ambas as condições.
4.3. Risk-Based Approval Gates, Human-in-the-Loop e Separation of Duties: calibrando autonomia por criticidade
Human-in-the-loop pode ser um controle importante, mas aprovações genéricas introduzem falsa segurança. Uma interface que apresenta apenas a frase o agente deseja continuar não oferece informação suficiente para uma decisão responsável. O approval gate deve expor ação, recurso, argumentos materializados, origem dos dados relevantes, efeitos esperados, risco e alternativas. O operador precisa aprovar uma transação específica, não conceder confiança irrestrita ao raciocínio do modelo.
Uma política baseada em risco pode combinar irreversibilidade, sensibilidade dos dados, valor financeiro, alcance organizacional e incerteza das evidências. Operações de leitura de baixo impacto podem ser automáticas; atualizações reversíveis podem exigir limites e monitoramento; transferências, exclusões massivas e comunicações externas sensíveis demandam aprovação independente. Separation of duties impede que a mesma identidade prepare, aprove e execute uma operação que deveria exigir múltiplos controles.
Evite usar confidence score do LLM como única medida de risco. Confiança linguística não é calibração de autorização, e um agente comprometido pode expressar certeza elevada. Prefira sinais observáveis: classe da ferramenta, destino, política aplicável, divergência entre fontes, volume e histórico operacional. O score pode influenciar roteamento para revisão, mas a permissão final deve continuar sujeita a regras explícitas e verificáveis.
O custo humano exige atenção. Aprovações excessivas criam fadiga, atrasam processos e incentivam bypass. Meça taxa de aprovação, erros detectados, tempo de decisão, frequência de rejeições e proporção de interações sem valor informacional. Interfaces precisam facilitar comparação com estados anteriores e destacar mudanças críticas. O objetivo não é maximizar intervenção humana; é direcioná-la aos pontos em que sua decisão oferece ganho demonstrável de segurança superior ao custo operacional e à latência introduzida.
4.4. Fail-Closed Execution, Idempotency, Transaction Boundaries e Compensating Actions
Fail closed significa negar uma operação quando a autorização necessária não pode ser comprovada. Em sistemas distribuídos, entretanto, falhas parciais exigem modelagem mais precisa. Uma chamada pode ter sido executada no sistema externo, embora o agente tenha recebido timeout. Repeti-la sem estratégia de idempotência pode duplicar pagamentos, criar registros redundantes ou enviar comunicações múltiplas. Segurança, confiabilidade e semântica transacional tornam-se inseparáveis.
Cada mutação relevante deve receber um operation ID estável e, quando suportado, uma idempotency key reconhecida pelo serviço de destino. O orquestrador registra intenção, aprovação, tentativa, confirmação e estado final. Em caso de resposta inconclusiva, a primeira ação deve ser reconciliar o estado remoto, não gerar automaticamente nova operação. O estado do workflow precisa diferenciar desconhecido de falhou, pois esses resultados exigem decisões operacionais distintas.
Transações distribuídas nem sempre permitem rollback atômico. Para integrações com CRM, ERP e serviços financeiros, padrões de saga e compensating actions podem restaurar consistência parcial. Uma compensação, porém, não apaga efeitos externos: uma mensagem já enviada ou um dado já exfiltrado não pode ser recuperado por uma chamada inversa. Classifique ações conforme reversibilidade real e determine approval gates antes dos pontos de não retorno.
Há ainda uma distinção entre continuidade e autorização. Retomar um workflow após falha não deve reutilizar indefinidamente uma aprovação antiga. Revise validade temporal, estado do recurso, identidade e política antes de prosseguir. Mecanismos de retry precisam respeitar limites de custo e não ampliar privilégios para superar erros. O design correto torna a execução previsível sob falhas, mantém trilhas auditáveis e evita que a recuperação automática se converta em um caminho alternativo para operações não autorizadas.
5. Security Evaluation: demonstrando empiricamente que a arquitetura resiste a ataques
A avaliação de segurança de AI Agents não pode limitar-se a verificar se o modelo recusa instruções suspeitas. O resultado relevante é observar se uma cadeia adversarial consegue produzir um efeito proibido, divulgar informação restrita ou contornar uma política. Uma resposta linguisticamente segura pode esconder uma ferramenta já executada; uma resposta confusa pode ser inofensiva se os pontos de enforcement impediram todas as ações perigosas.
Um programa de evaluation precisa operar em três níveis. No nível comportamental, mede-se a tendência do modelo a seguir conteúdo malicioso. No nível de workflow, observa-se a sequência de chamadas, mudanças de estado e delegações. No nível de enforcement, verifica-se se políticas independentes bloquearam operações não autorizadas mesmo quando o agente tentou executá-las. Esses níveis não devem ser confundidos em um único indicador agregado de segurança.
A suíte deve representar ameaças reais com cenários reproduzíveis, incluindo prompt injection indireto, tool poisoning, mudanças de escopo, uso indevido de credenciais, contaminação de memória e falhas entre agentes. Os testes precisam incluir caminhos legítimos equivalentes para mensurar false positives e perda de utilidade. Testar somente se ataques são bloqueados favorece sistemas inutilizáveis, que parecem seguros por não realizarem nenhuma operação.
Para decisões no nível Staff, exige-se uma abordagem orientada a evidências: datasets versionados, métricas com denominadores transparentes, seeds e configurações registradas, avaliação de regressões e análise de cobertura do attack graph. Segurança não é um certificado derivado de um benchmark isolado. É uma hipótese operacional continuamente testada contra novas ferramentas, modelos, políticas e padrões de ataque, com critérios explícitos para bloquear um release quando a evidência deixa de sustentar o risco aceito.
5.1. Threat-Driven Evaluation: construindo adversarial test suites a partir de OWASP Agentic AI, MITRE ATLAS e cenários reais
Taxonomias como OWASP Top 10 for Agentic Applications e MITRE ATLAS ajudam a organizar ameaças, mas não devem ser copiadas diretamente como uma lista genérica de testes. O ponto de partida é o attack graph do produto: quais recursos são críticos, quais superfícies recebem conteúdo não confiável e quais combinações de permissões permitem alcançar um estado proibido. A taxonomia orienta cobertura; a arquitetura determina relevância.
Transforme cada ameaça em um cenário com preconditions, attacker control, objetivo malicioso, comportamento permitido e oracle de sucesso. Em uma aplicação financeira, um caso pode inserir instruções falsas em um anexo, provocar uma chamada de atualização bancária e verificar se a alteração foi efetivamente bloqueada. Um teste que examina apenas a resposta textual do agente não consegue distinguir tentativa, bloqueio e comprometimento consumado.
O dataset precisa abranger múltiplos pontos de entrada e graus de controle do atacante. Inclua documentos, mensagens, resultados de busca, descrições de ferramentas, memórias e comunicações entre agentes. Modele também ataques sequenciais que primeiro obtêm informação, depois alteram contexto e finalmente tentam executar uma ação. Cada cenário deve produzir evidências de chamadas, decisões de política e estado final, permitindo diagnóstico de falhas sem depender de um avaliador linguístico.
A manutenção da suíte requer owner, versionamento, severidade e rastreabilidade até um controle arquitetural. Ao descobrir um incidente, crie uma regressão que capture o mecanismo causal, não apenas o texto exato do payload. Essa prática evita overfitting a exemplos conhecidos. O resultado valioso é um mapa de ameaças para controles e testes, capaz de revelar tanto riscos não avaliados quanto defesas que existem apenas como intenção documental.
5.2. Agent Red Teaming: ataques multi-turn, indiretos, adaptativos e exploratórios contra ferramentas e memória
Red teaming efetivo precisa reproduzir adversários que observam respostas e ajustam estratégias. Ataques de uma única mensagem oferecem uma visão limitada porque agentes reais recebem contexto incremental, corrigem erros e mantêm memória. Um invasor pode começar com solicitações benignas, introduzir uma fonte adulterada, induzir um resumo enviesado e explorar a confiança acumulada em passos posteriores. O comportamento adversarial emerge da sequência, não necessariamente de um payload evidente.
Uma avaliação madura varia orçamento de tentativas, tempo, acesso ao ambiente e conhecimento da arquitetura. Cenários black-box medem exploração externa com visibilidade limitada. Cenários gray-box assumem conhecimento de nomes de ferramentas e workflows. Cenários com controle de um servidor MCP ou repositório de documentos simulam comprometimento da supply chain. Essas condições devem ser declaradas para evitar comparações enganosas entre resultados obtidos sob capacidades de ataque diferentes.
Defina oracles baseados em efeitos verificáveis: alteração de registro, leitura de recurso proibido, chamada a destino externo ou persistência de memória indevida. Registre o caminho exato percorrido e classifique falhas segundo camada: modelo, roteamento, autorização, execução ou observabilidade. Um bloqueio no PEP é sucesso de contenção mesmo que o LLM tenha produzido uma chamada maliciosa. Essa distinção direciona investimento para o controle adequado.
Red teaming também deve avaliar disponibilidade e custo. Um atacante pode induzir loops, explosão de subtarefas ou repetição de consultas caras. Imponha ambientes isolados, dados sintéticos e limites estritos para que o próprio teste não gere incidentes. Finalmente, alterne conjuntos públicos, privados e inéditos, preservando uma amostra não utilizada para tuning. Caso contrário, a equipe pode otimizar o sistema para um benchmark enquanto permanece vulnerável a estratégias semanticamente diferentes.
5.3. Security Metrics: Attack Success Rate, Policy Violation Rate, Unauthorized Action Rate e Detection Coverage
Attack Success Rate, ou ASR, precisa ter um denominador explícito. A fração de ataques bem-sucedidos entre tentativas válidas não equivale à fração de sessões comprometidas, porque um atacante pode realizar diversas tentativas por objetivo. Reporte sucesso por tentativa, por cenário e por orçamento de ataque. Inclua intervalos de confiança e segmentação por tipo de entrada, ferramenta, severidade e versão de modelo para evitar conclusões derivadas de amostras pequenas.
Policy Violation Rate descreve a proporção de decisões ou ações que violam uma política definida. Unauthorized Action Rate deve contabilizar efeitos realmente produzidos sem autorização, distinguindo ações propostas, bloqueadas e confirmadas. Se cem chamadas proibidas forem sugeridas e todas forem impedidas pelo gateway, há um sinal preocupante na camada cognitiva, mas zero efeitos não autorizados observados. Agregar ambos os números destrói informação arquitetural essencial.
Detection Coverage exige um universo de referência. Pode representar a fração de técnicas testadas que geram alertas, ou a proporção de incidentes sintéticos corretamente identificados. Acrescente false positive rate, mean time to detect e mean time to contain. Para fluxos legítimos, acompanhe task completion rate e approval burden. Um sistema com ASR baixa e taxa de conclusão igualmente baixa não demonstra superioridade operacional.
A avaliação econômica pode introduzir expected loss, considerando probabilidade de comprometimento, impacto e custo de controles. Evite apresentar esse valor como precisão matemática quando as probabilidades forem estimadas de forma subjetiva. Use faixas e análise de sensibilidade. Dashboards de segurança devem permitir drill-down até traces e decisões de política, incluindo cenários que falharam por infraestrutura. Métricas úteis não apenas ranqueiam modelos; elas revelam qual fronteira de confiança precisa ser fortalecida antes do próximo deployment.
5.4. Continuous Security Evaluation: trace grading, regression gates, shadow testing e validação de mudanças
A postura de segurança pode mudar quando o modelo, o prompt, o catálogo de ferramentas, a política ou uma dependência externa são atualizados. Por isso, evaluation precisa fazer parte do ciclo de entrega, com artefatos versionados e critérios objetivos de promoção. Um regression gate deve reprovar mudanças que introduzam efeitos não autorizados em cenários críticos, mesmo quando métricas agregadas de qualidade de resposta melhoram.
Trace grading permite avaliar trajetórias completas: decisões intermediárias, argumentos de ferramentas, autorizações, execuções e resultados. Julgadores baseados em LLM são úteis para interpretar justificativas e classificar comportamentos ambíguos, porém o oracle de segurança deve preferir verificações determinísticas de estado e política. Para mudanças financeiras, o teste deve consultar o recurso simulado e comprovar que nenhuma alteração indevida ocorreu. A avaliação textual funciona como complemento diagnóstico.
Shadow testing pode reproduzir entradas reais em um ambiente isolado, comparando propostas de ferramentas entre versões sem efetuar mutações externas. Isso ajuda a identificar ampliação de escopo, diferenças de roteamento e degradação em tarefas legítimas. Entretanto, executar uma versão em sombra com credenciais de produção seria uma violação do propósito do isolamento. Utilize datasets minimizados, tokens sem privilégios de escrita e destinos controlados.
O processo de release deve incluir cobertura por risco, limites estatísticos, revisão humana de casos severos e rollback operacional. Alterações em policy engine e ferramenta precisam de testes conjuntos, não apenas validações unitárias separadas. Em produção, monitore drift de comportamento e novos padrões de abuso, alimentando a suíte com incidentes e quase incidentes. A métrica de maturidade não é quantas avaliações foram executadas, mas quão rapidamente evidências novas alteram decisões de deployment, políticas e prioridades de arquitetura.
6. Runtime Security e Operational Resilience: mantendo agentes sob controle em produção
Mesmo uma arquitetura que passou por threat modeling e evaluation pode falhar quando encontra ambientes reais, integrações mutáveis e padrões de uso imprevistos. Runtime security precisa tratar o agente como uma aplicação distribuída que executa operações potencialmente privilegiadas, não como uma conversa a ser moderada. O que importa é detectar desvio comportamental, limitar efeitos externos e preservar capacidade de investigação quando uma sequência sai do caminho esperado.
A pilha operacional deve combinar traces correlacionados, decisões de política, métricas de execução, eventos de identidade e registros de mutação. Observabilidade precisa responder quais dados influenciaram uma decisão, quais capacidades estavam disponíveis, qual principal foi utilizado e qual estado foi efetivamente alterado. A resposta não pode depender exclusivamente de explicações retrospectivas geradas pelo modelo, porque elas não constituem evidência confiável do caminho executado.
Resilience também envolve isolamento de falhas. Um servidor de ferramentas indisponível não deve provocar uma cadeia ilimitada de retries; uma falha de aprovação não pode ser interpretada como consentimento; uma anomalia de gasto precisa interromper exploração de ferramentas antes de esgotar orçamento. Em sistemas com subagentes, budgets, deadlines e políticas devem ser propagados de maneira verificável, com limites globais que não podem ser reiniciados por delegação.
A estratégia de operação exige playbooks específicos para incidentes agênticos, incluindo revogação de credenciais, suspensão de capacidades, congelamento de workflows e reconstrução de rastros. A maturidade se mede pela capacidade de conter rapidamente uma execução sem interromper indiscriminadamente toda a plataforma. Segurança em produção não consiste em prever todas as sequências possíveis, mas em manter o raio de impacto limitado quando ocorrer um comportamento não antecipado.
6.1. Security Observability: correlacionando identidade, decisões, permissões, tool calls e efeitos externos
Logs de prompts e respostas não são suficientes para auditoria de agentes. Uma trilha de segurança precisa correlacionar request ID, execution ID, agent version, user principal, workload identity, policy decision, tool arguments e resultado de cada side effect. OpenTelemetry e padrões de distributed tracing podem organizar essa telemetria, desde que os eventos preservem semântica de autorização e não apenas duração de spans.
Para cada chamada, registre a proposta original, os argumentos após canonicalização, o recurso de destino, a política avaliada e a decisão do enforcement point. Em operações assíncronas, transporte correlation IDs através de filas e callbacks para reconstruir causalidade. A confirmação de uma API externa deve ser diferenciada de uma simples resposta do modelo dizendo que concluiu a tarefa. Quando possível, registre o estado observado após a operação ou a referência imutável ao evento de negócio.
O desenho de observabilidade precisa preservar confidencialidade. Registrar prompts completos, payloads e tokens pode criar um novo repositório de dados sensíveis. Adote redaction, data minimization, controles de acesso por função, retenção diferenciada e segregação de tenants. Hashes e referências permitem vincular artefatos sem reproduzir todo o conteúdo. A escolha depende da necessidade forense, da regulação e do impacto de um vazamento dos próprios logs.
Trace completeness também deve ser avaliada. Se uma ferramenta privilegiada consegue operar sem emitir evento correlacionado, a investigação fica cega justamente no ponto crítico. Defina SLOs de cobertura de traces, latência de ingestão e integridade de eventos, além de alertas para chamadas sem policy decision associada. Observabilidade não substitui enforcement, mas transforma falhas de segurança em fatos verificáveis e permite localizar a fronteira que deixou de cumprir seu contrato.
6.2. Runtime Risk Scoring, Behavioral Anomaly Detection e Adaptive Enforcement
Risk scoring em runtime pode incorporar características observáveis como classe da ferramenta, volume de dados, destino, quantidade de ações, divergência entre fontes e histórico de comportamento. Esses sinais ajudam a priorizar fiscalização, mas um score estatístico não deve substituir regras rígidas. Se uma política proíbe exportar dados restritos para domínios externos, uma pontuação baixa de risco não autoriza exceção. O score orienta intensidade de controle dentro dos limites já permitidos.
Behavioral anomaly detection é útil para identificar mudanças como aumento súbito de consultas, tentativas repetidas de acessar recursos negados, sequências incomuns de ferramentas ou alteração de padrão de destinatários. Entretanto, agentes realizam tarefas heterogêneas e podem variar legitimamente conforme o contexto. Baselines devem ser condicionadas por workflow, identidade, ferramenta e horário, com medidas para concept drift e observação de falsos positivos em tarefas raras.
Adaptive enforcement pode elevar o nível de proteção diante de sinais acumulados: exigir aprovação, reduzir quotas, restringir ferramentas ou mover execução para ambiente mais isolado. Essas transições precisam ser determinísticas, explicáveis e testáveis. Um classificador pode sugerir risco elevado, mas uma política decide quais obrigações adicionais serão impostas. Defina também histerese e critérios de retorno ao modo normal, evitando oscilações que prejudiquem disponibilidade.
Avalie detecção com traces adversariais e fluxos legítimos, separando precisão, recall, atraso de alerta e custo por evento. Um sistema que alerta após a conclusão de uma transferência não oferece a mesma contenção que um PEP capaz de barrá-la. Faça distinção entre controles preventivos e detectivos. O ganho real de adaptive enforcement deve ser demonstrado pela redução de efeitos não autorizados, sem crescimento desproporcional de latência, intervenção humana ou indisponibilidade operacional.
6.3. Circuit Breakers, Kill Switches, Rate Limits e Resource Budgets para contenção de falhas
Circuit breakers impedem que dependências degradadas sejam chamadas indefinidamente, enquanto kill switches oferecem a capacidade de interromper ações potencialmente perigosas. Em AI Agents, ambos precisam operar sobre capacidades e workflows, não apenas sobre endpoints. É possível desabilitar temporariamente ferramentas de escrita financeira, preservando consultas de leitura e suporte a tarefas não críticas. Esse particionamento reduz o custo de conter um incidente sem paralisar toda a organização.
Rate limits devem considerar mais que requisições por segundo. Orçamentos podem limitar tokens, número de tool calls, profundidade de delegação, valor financeiro movimentado, registros alterados e volume exportado. A contabilização deve abranger a árvore inteira de execução para impedir que um agente reinicie seus limites criando subtarefas. Limites por usuário, tenant e workflow ajudam a evitar que um único processo consuma capacidade compartilhada ou amplie indevidamente seu alcance.
Um kill switch efetivo precisa atuar onde o efeito acontece. Interromper a geração do modelo não revoga uma operação já enviada a um serviço externo, nem cancela automaticamente jobs assíncronos. Portanto, implemente cancelamento propagado, invalidação de credenciais, suspensão de filas e bloqueio no gateway. Para ações irreversíveis, a prevenção antes do commit continua indispensável. Teste periodicamente a capacidade de suspensão, incluindo falhas de rede e processos parcialmente concluídos.
O trade-off está entre reação rápida e disponibilidade. Limites muito estreitos penalizam fluxos legítimos; limites permissivos permitem exploração econômica e operacional. Calibre budgets a partir de distribuições reais de uso, classes de risco e cenários adversariais. Defina owners autorizados a ativar controles emergenciais, registros de decisão e critérios de reabilitação. A arquitetura só possui contenção confiável quando os mecanismos foram exercitados antes de um incidente real e demonstraram efeito no sistema de destino.
6.4. Incident Response, Forensic Replay, Auditability e Recovery em sistemas multiagentes
Incident response para AI Agents exige procedimentos além dos playbooks convencionais de aplicações web. Um incidente pode envolver conteúdo malicioso recuperado, alteração de memória, uso indevido de ferramentas, persistência em subagentes e propagação para sistemas externos. A primeira etapa é conter capacidades e credenciais comprometidas, preservando evidências suficientes para reconstruir decisões e efeitos. Simplesmente atualizar o prompt não elimina estados adulterados nem desfaz operações executadas.
Forensic replay requer reconstituir versões de modelo, prompts, ferramentas, políticas, documentos relevantes e sequência de eventos. A geração probabilística pode não reproduzir exatamente o mesmo texto, mesmo com configurações semelhantes. Por isso, diferencie replay determinístico de chamadas e estados registrados de uma reexecução experimental do raciocínio. A investigação deve fundamentar-se em eventos observados, não em uma narrativa posteriormente reconstruída pelo LLM.
A recuperação pode exigir invalidar memórias, corrigir dados corporativos, revogar tokens, reconstruir índices RAG e revisar aprovações concedidas. Em workflows distribuídos, mantenha inventário de side effects, operações pendentes e compensações possíveis. Registros de auditoria devem identificar quais recursos realmente foram afetados, para que ações corretivas não se baseiem apenas em suposições sobre o alcance do agente. Preserve evidências com controle de acesso e cadeia de custódia proporcional à criticidade.
Postmortems precisam analisar falhas de controle, não somente comportamento do modelo. Pergunte por que a fonte não confiável conseguiu influenciar uma decisão privilegiada, por que a política não bloqueou o efeito e por que a detecção demorou. Transforme essas respostas em regressões reproduzíveis, alterações de arquitetura e melhorias de telemetria. Um programa operacional maduro incorpora lições de incidentes na plataforma compartilhada, reduzindo o risco de repetir a mesma classe de falha em outros agentes.
7. Architectural Trade-offs e Economics: decidindo quanto de autonomia é aceitável
Segurança arquitetural não é maximizar o número de controles instalados. É selecionar mecanismos cuja redução marginal de risco justifique custo, latência, complexidade e perda eventual de autonomia. Um fluxo de classificação documental, por exemplo, tolera escolhas probabilísticas que seriam inadequadas em transferência financeira. Projetar ambos sob uma política única pode produzir um sistema caro, inflexível e ainda vulnerável nos pontos de maior impacto.
A decisão deve partir do business capability map e classificar workflows segundo alcance operacional, reversibilidade, criticidade dos dados e necessidade de interpretação contextual. Para tarefas bem definidas, uma sequência determinística com checkpoints e validação pode oferecer custo inferior e auditabilidade superior. Para atividades exploratórias, a autonomia pode justificar-se quando existem limites de capacidade, orçamento e efeitos externos. O objetivo é escolher o menor grau de liberdade capaz de entregar o resultado esperado.
O custo total precisa incluir tokens, execução de ferramentas, isolamento, telemetria, avaliação adversarial, revisão humana, operações e manutenção das integrações. Também é necessário estimar perdas decorrentes de indisponibilidade, decisões incorretas e violações de segurança. Esses valores são incertos, mas ignorá-los cria uma comparação enviesada em favor de arquiteturas que aparentam ser mais baratas apenas porque externalizam riscos para operações e clientes.
A governança Staff/Principal transforma essa análise em decisões verificáveis: quais capacidades serão autônomas, quais exigem aprovação, quais ficam permanentemente fora do alcance do agente e quais evidências autorizam mudanças. A arquitetura segura não é aquela que promete eliminar prompt injection ou comportamento inesperado. É aquela que mantém o sistema economicamente útil enquanto reduz as consequências de uma falha probabilística a um envelope de risco conhecido, monitorado e aceito por responsáveis identificáveis.
7.1. Security vs. Autonomy vs. Latency: o custo arquitetural de cada camada de controle
Cada camada de segurança adiciona possíveis hops, validações, dependências e oportunidades de falha. Um policy decision remoto pode aumentar latência; uma sandbox efêmera exige inicialização; uma aprovação humana pode elevar o tempo de conclusão de segundos para horas. Entretanto, comparar apenas medianas de resposta ignora efeitos importantes: incidentes, retries, correções manuais e indisponibilidade decorrente de ações indevidas também possuem custo temporal.
Modele latência pelo caminho crítico de execução. Separe tempo de inferência, retrieval, avaliação de política, obtenção de credenciais, ferramenta e espera por aprovação. Observe p95 e p99, não somente média. Operações independentes podem ser paralelizadas, mas a autorização final precisa utilizar os argumentos efetivamente executados. Caching de políticas reduz custo quando o contexto permanece válido; para recursos mutáveis e ações críticas, pode introduzir decisões obsoletas.
A autonomia deve ser calibrada pela criticidade da ação. Um agente pode pesquisar alternativas livremente, mas solicitar aprovação antes de comprometer orçamento. Também pode preparar um conjunto de modificações e submetê-lo a uma única revisão transacional, reduzindo fadiga sem conceder autorização ampla para mutações futuras. Esse padrão separa exploração de compromisso e melhora a experiência sem enfraquecer os pontos de enforcement.
Uma análise Staff considera fronteiras de Pareto: para cada desenho, compare task completion, tempo, custo e risco residual. Uma solução é arquiteturalmente dominada quando outra entrega utilidade igual ou superior com menor latência e menor exposição. Não existe ponto ótimo universal; o resultado depende de impacto de negócio e tolerância a incidentes. O erro é otimizar velocidade de resposta sem medir o custo das consequências produzidas pelas respostas.
7.2. Risk-Adjusted TCO: custos de guardrails, evaluation, observability, infraestrutura e intervenção humana
Total Cost of Ownership de um sistema agêntico inclui gastos diretos e custos condicionados à ocorrência de falhas. O componente direto abrange inferência, armazenamento, ferramentas externas, runtime isolado, telemetria, políticas e manutenção. O indireto envolve triagem de alertas, aprovações, reprocessamentos, atendimento a incidentes, perdas operacionais e exposição contratual. Uma avaliação econômica que considera apenas preço por token subestima justamente a complexidade que diferencia agentes de aplicações informacionais.
Um modelo risk-adjusted pode expressar custo esperado como TCO operacional acrescido da soma dos cenários de perda ponderados por probabilidade. Essa formulação é útil para comparar opções, mas exige transparência sobre premissas. Probabilidades de ataque costumam ser incertas, particularmente em sistemas novos. Utilize faixas, cenários otimista e adverso e sensitivity analysis, identificando quais variáveis alteram a decisão. Evite converter estimativas frágeis em números excessivamente precisos.
Guardrails também apresentam retornos marginais distintos. Um filtro adicional de conteúdo pode reduzir ataques simples, enquanto um gateway com autorização contextual impede uma classe inteira de efeitos proibidos. Evaluation contínua demanda investimento, mas reduz custo de regressões. Observabilidade ampla ajuda investigação, porém armazenamento indiscriminado de prompts pode criar despesas e riscos de privacidade. O cálculo deve considerar controles preventivos, detectivos e corretivos de forma diferenciada.
Para priorização, relacione cada investimento a um caminho concreto de ataque, à redução plausível de blast radius e ao impacto em task success rate. Faça experimentos controlados com configurações alternativas e reporte custo por tarefa legítima concluída, não apenas custo por execução iniciada. Uma arquitetura mais cara por chamada pode ser economicamente superior quando reduz retrabalho, intervenção humana e incidentes. Segurança precisa ser avaliada como engenharia de risco e produto, não como uma linha isolada de compliance.
7.3. Deterministic Workflows vs. Autonomous Agents: quando reduzir autonomia produz arquiteturas superiores
Nem toda tarefa que pode ser realizada por um AI Agent deveria ser implementada com autonomia aberta. Em processos com regras estáveis, poucos estados e efeitos previsíveis, workflows determinísticos oferecem menor variância, testes mais simples e autorização explícita. O LLM pode continuar útil na extração de dados, classificação de documentos ou geração de propostas, enquanto a sequência de execução permanece governada por uma máquina de estados com transições conhecidas.
O padrão híbrido costuma ser mais robusto: componentes probabilísticos interpretam informações ambíguas e produzem candidatos estruturados; etapas determinísticas verificam invariantes, solicitam aprovações e realizam mutações. Um agente de contas a pagar pode interpretar notas fiscais, detectar divergências e sugerir classificação. A liquidação, entretanto, deve seguir políticas de valor, destinatário, segregação de funções e reconciliação. Essa divisão preserva ganhos cognitivos sem transferir autoridade financeira ao modelo.
Autonomia mais ampla faz sentido quando a decomposição da tarefa não é conhecida antecipadamente, existem múltiplas fontes heterogêneas e o valor da exploração supera o custo de decisões adicionais. Mesmo nesse cenário, imponha bounded planning, allowed tool sets, deadlines e limites de delegação. A liberdade de escolher o próximo passo não deve implicar liberdade para redefinir os objetivos, mudar políticas ou ampliar acesso. Replanejamento pode ser flexível sem tornar o espaço de ações ilimitado.
A escolha deve ser orientada por experimentos comparáveis. Meça qualidade, cobertura de casos, latência, custo por tarefa, incidentes e facilidade de depuração para versões determinísticas, híbridas e autônomas. Muitos projetos confundem complexidade arquitetural com sofisticação. No nível Principal, maturidade é reconhecer quando a melhor inovação consiste em remover um loop agêntico, simplificar a cadeia de dependências e produzir um sistema que equipes de operação conseguem compreender e controlar.
7.4. Production Readiness e Residual Risk: critérios de aceitação, evidências de segurança e decisões de arquitetura no nível Staff/Principal
Production readiness para AI Agents precisa ser um julgamento fundamentado em evidências, não uma checklist marcada por conveniência. Antes do deployment, exija inventário de capabilities, attack graph atualizado, políticas testadas, identidade de workload, isolamento proporcional ao risco, oracles de avaliação e mecanismos operacionais de contenção. Nenhum item isolado garante segurança, mas a ausência de controles críticos deve impedir a promoção de workflows com efeitos privilegiados.
Estabeleça critérios de aceitação vinculados ao risco. Exemplos incluem zero efeitos não autorizados nos cenários críticos testados, cobertura documentada das principais trust boundaries, bloqueio demonstrado de bypasses de autorização e tempos máximos de revogação exercitados em simulações. Zero incidentes observados em um conjunto finito não prova probabilidade nula de falha. Relate tamanho da amostra, condições experimentais, classes não cobertas e incertezas restantes para evitar excesso de confiança.
Residual risk deve possuir owner explícito e decisão registrada. Um Architecture Decision Record pode documentar alternativas consideradas, ameaças mitigadas, riscos aceitos, custos adicionais e condições que exigem revisão. Escapes de política requerem expiração e controle compensatório. Mudanças de modelos, ferramentas, fornecedores ou permissões precisam disparar reavaliação quando alterarem uma hipótese central do desenho. A aprovação de uma versão não equivale à autorização permanente de suas evoluções.
O papel de Staff e Principal Engineers é transformar segurança em uma propriedade sistêmica que sobreviva a novas features, equipes e modelos. Isso exige interfaces coerentes, padrões reutilizáveis, métricas orientadas a efeitos e capacidade comprovada de conter incidentes. O princípio final é simples, embora exigente: a arquitetura deve assumir que o agente pode errar, ser manipulado ou interpretar mal uma intenção. O sistema continua confiável quando nenhuma dessas condições basta, isoladamente, para produzir uma ação fora dos limites autorizados.
SRE para AI Systems: Arquitetura de Confiabilidade e Garantias de Produção em Sistemas…
Observability para AI Agents em Produção: Como Observar Comportamento, Decisões e Trajetórias,…
Agent Evaluation em Produção: Outcomes, Trajectories e Decision Quality em Sistemas Agênticos